-
给设备补录一条昨天的温度,忘了写时间戳,这条数据会记到什么时候?
-
按原时间重写一个读数,旧值会被覆盖吗?
-
只想清理一段历史数据,又该用哪条命令?
11 月 11 日的 IoTDB 入门直播用工厂、车间和设备演示了树模型与表模型下的数据写入和删除。本文结合直播演示整理出一套可操作的判断方法与关键命令:先认清数据如何定位,再理解覆盖规则,最后确认删除范围。
一、先看数据如何定位:路径还是标签
在 IoTDB 中,一条时序数据可以用三个问题来定位:来自哪台设备、测量的是什么、发生在什么时间。
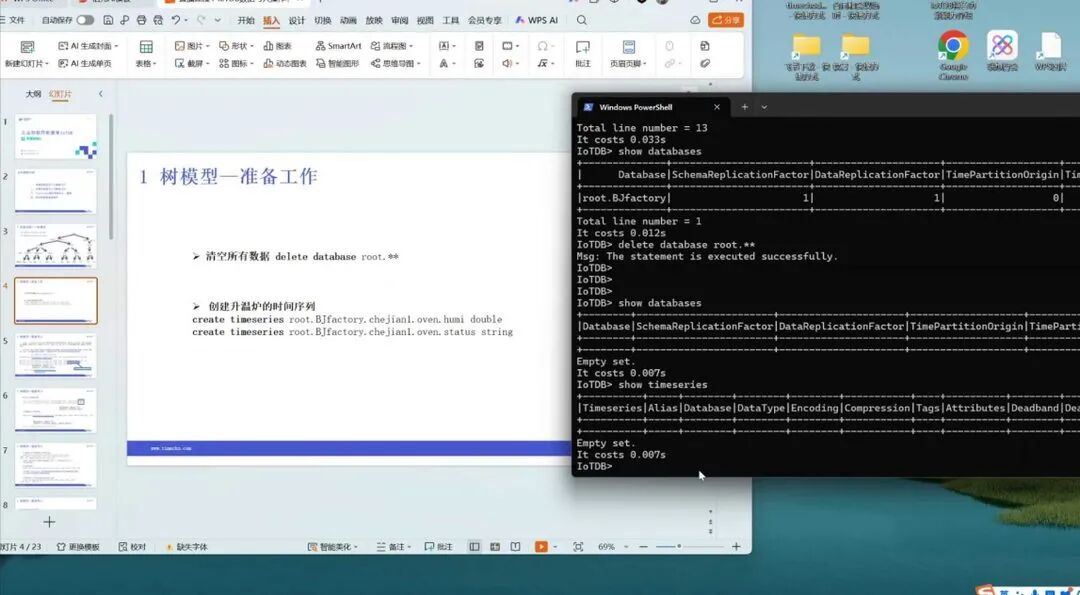
树模型把工厂、车间、设备和测点组织成层级路径。创建时间序列时定位到测点;写入时先定位设备,再指定要写入的测点。
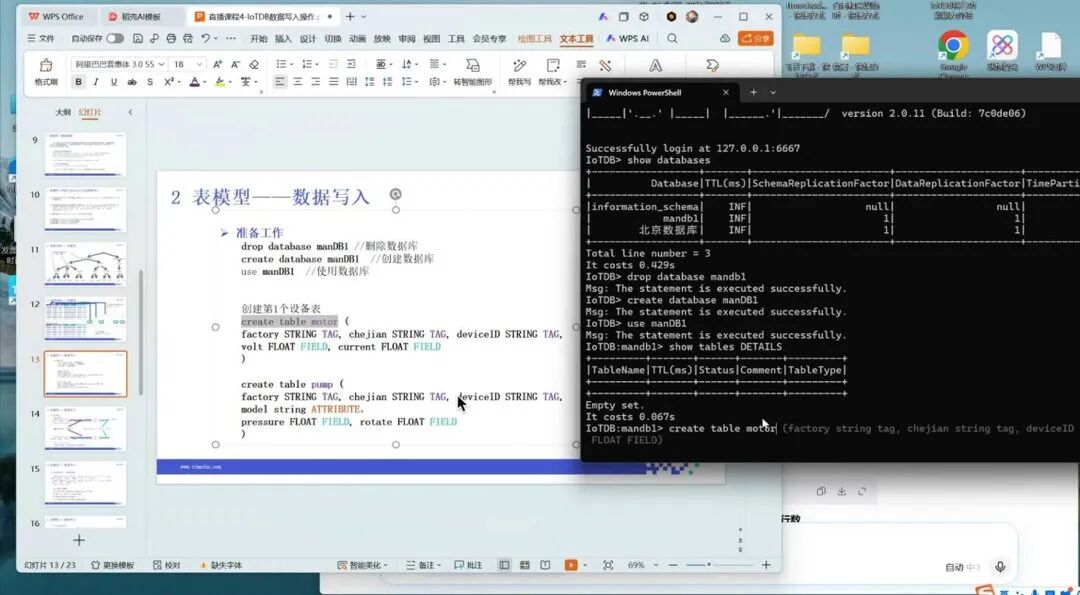
表模型则把同一类设备放在一张表里,通过工厂、车间、设备编号等 TAG 组合区分设备,以 FIELD 记录随时间变化的测量值,并可用 ATTRIBUTE 保存相对稳定的设备属性。
简而言之,IoTDB 树模型以路径表达设备关系,表模型以标签组合表达设备身份。
| 判断维度 | IoTDB 树模型 | IoTDB 表模型 |
|---|---|---|
| 设备怎么定位 | 层级路径 | TAG 标签组合 |
| 测点怎么组织 | 路径末端的时间序列 | 表中的 FIELD 测量列 |
| 结构准备 | 直播演示了未预建序列时的无模式写入 | 需先定义表结构 |
创建侧的命令也可对照记忆:树模型用 create timeseries 声明完整路径;表模型则用 create table 定义 TAG / FIELD / ATTRIBUTE 列。
二、写入前先定时间:事件时间不等于写入时间
直播展示了 IoTDB 写入可使用可读时间、长整型时间戳、now(),也可以省略时间列。省略时,IoTDB 会使用当前时间补齐,方便之处在于少写一个字段;需要留意的是,这个时间来自执行时的系统时钟,不一定等于设备采集或业务事件实际发生的时间。
| 时间写法 | 含义 | 使用时的注意点 |
|---|---|---|
| 可读时间 | 直接表达日期和时分秒 | 个位数的月、日要在前面补 0,否则有时会报错;也可用大写字母 T 分隔年月日与时分秒 |
| 长整型时间戳 | 以数值表示时间 | 确认单位及其对应的实际时刻 |
| now() 或省略时间 | 采用数据库当前时间 | 不要误当成设备事件时间 |
实时采集、历史回放和跨系统对账应先约定时间口径。需要重放、补录或审计的数据,应优先明确传入业务事件时间。批量写入时尤其要明确每行时间,避免默认时间造成碰撞、覆盖或其他非预期结果。
三、同一时间再次写入:覆盖写入要先约定
直播演示中,对同一设备、同一测点和同一时间戳再次写入,新值会替换原值;表模型也展示了同一设备身份和时间位置上的测量值重写。这有利于修正错误数据和补录遗漏值;但要注意,同一设备的两笔历史温度如果被写到了同一个时间戳,后写的值就会覆盖先写的值。分两条 INSERT 写入时,如果都省略了时间戳,而且恰好被补成同一个时间,也会发生这种情况。
因此,IoTDB 项目上线前要约定哪些数据允许重写、如何判断重复、事件时间和入库时间是否分别保留,以及修正值是否需要记录来源或版本。重复写入的行为由数据库定义,允许覆盖的条件则应由业务规则决定。
四、无模式写入省了预建步骤,也要防止结构失控
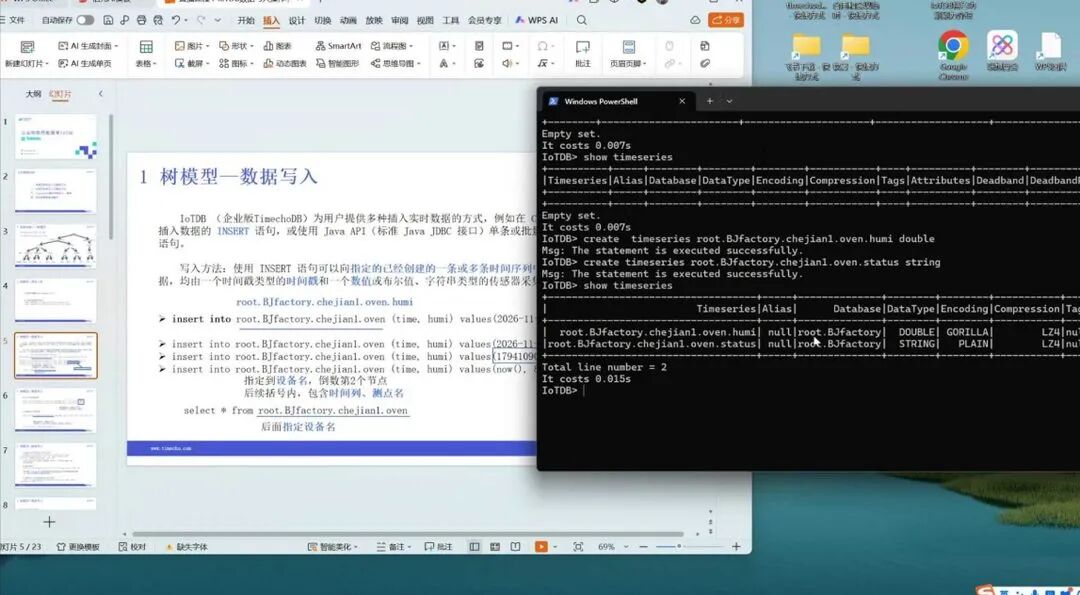
IoTDB 树模型支持无模式写入。开启自动创建模式后,即使事先没有为新测点创建时间序列,也可以直接写入数据。IoTDB 会根据首次写入的值推断数据类型,并创建对应的时间序列。设备和测点陆续接入时,这可以省去逐个建序列的步骤。
如果上线前已经有明确的测点清单和类型要求,建议按清单提前创建。比如,温度测点后续会上报小数,第一次上报的值却可能刚好是整数。提前将测点定义为 FLOAT 或 DOUBLE,就能让序列类型从一开始符合采集要求。
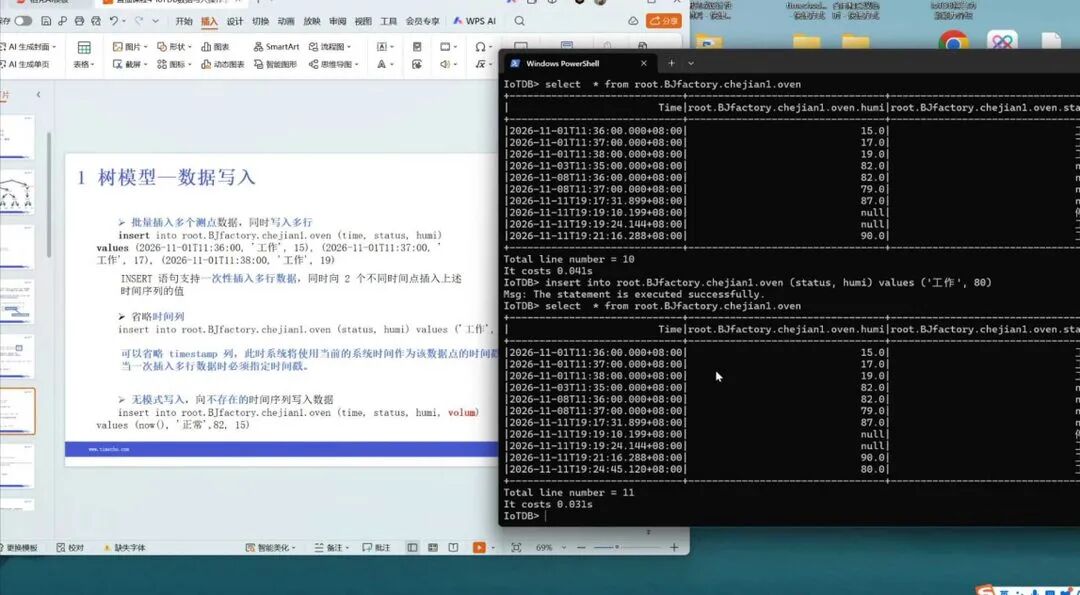
注:表模型中通过 insert 语句无法自动创建表,表结构必须先定义。
五、对齐序列:对齐不等于每列都有值
同一设备的多个测点按共同时间轴采集时,IoTDB 树模型可以使用对齐序列组织数据,写入时需采用相应的对齐写入方式。但“对齐”不代表每个时间点的每个测点都一定有值,查询结果中仍可能出现空值。是否要求同批测点齐全,应由采集协议和业务校验负责。
六、删除前先问:删的是数据,还是对象
在 IoTDB 中,“删除”可能指删除某段时间范围内的数据点、清空某条序列中的数据、删除符合标签条件的设备,也可能是删除时间序列或数据库对象。它们影响的层级不同,不能仅凭一句自然语言或一个宽泛条件直接执行。
直播明确区分了删除序列中的数据和删除时间序列本身:前者执行后,序列仍在,只是数据被清除;后者会移除序列定义。表模型的演示还包括按时间范围删除数据、按标签条件删除设备。
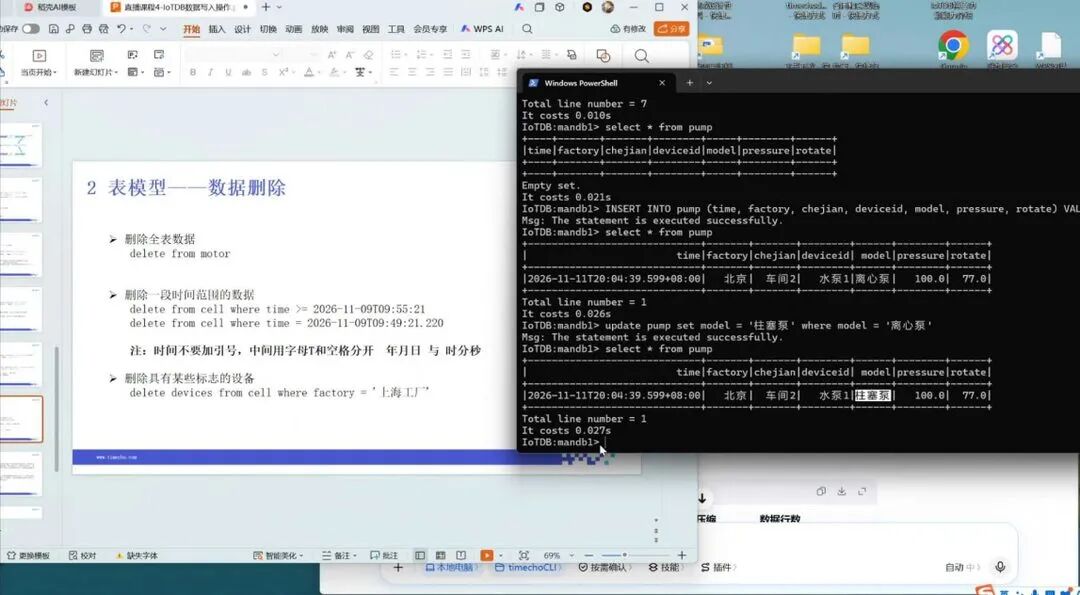
直播演示前的清库命令 delete database root.** 属于高风险操作,会删除所有数据库及其内部全部数据,需要特别注意。
七、AI 能执行操作,但不能替人定义边界
直播还演示了通过 AI 助手调用数据库工具,完成建表、生成演示数据、查询和删除。AI 能根据提示识别部分标签与测量列,适合辅助探索和重复性操作;但“删除 state”可能指清空该序列的数据,也可能指移除序列对象,结果完全不同。
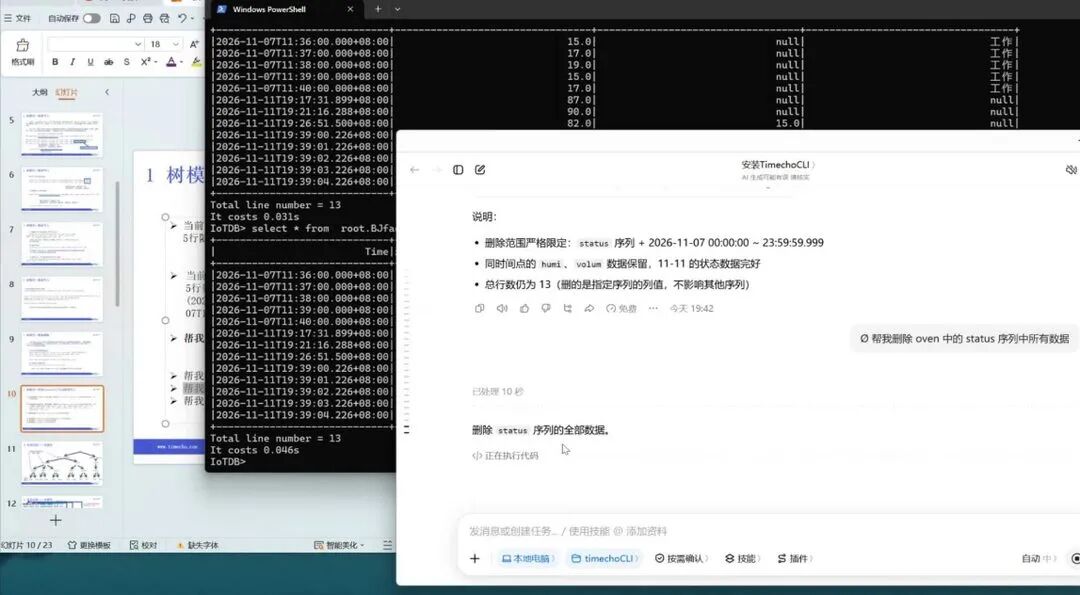
因此,让 AI 操作 IoTDB 时,应说明模型类型、目标对象、列和数据类型、时间范围及时区等更具体的命令,并要求先展示拟执行操作和预计影响范围。涉及覆盖、删除或结构变更时,先查询核验,再由有权限的人确认执行。
八、写入与删除,记住这五条
-
先约定业务事件时间与 IoTDB 写入时间的区别。
-
批量写入明确每行时间戳,并制定重复数据的覆盖策略。
-
无模式写入配套命名、类型和序列数量治理。
-
删除前核验条件命中的数据或对象,按影响范围分级确认。
-
AI 参与写入、覆盖和删除时,保留预览、验证和人工确认。
IoTDB 数据操作的关键,不是记住更多命令,而是知道数据如何被定位:树模型用路径组织设备和测点,表模型用标签组合标识设备;时间决定数据落点;同一位置再次写入可能覆盖原值;删除对象不同,影响范围也不同。
把这些边界想清楚,命令行、SDK 还是 AI 智能体,都只是不同的操作入口。可靠的数据操作始终遵循同一顺序:写入前定义数据身份,覆盖前明确重写规则,删除前验证影响范围。