温度、压力、振动、电流……这些时序数据如同设备的“心电图”,记录着运行状态,也留下了工厂专家调整参数、应对异常的操作轨迹。在许多企业,这些历史记录已经用于故障回溯、运行监测和报表分析,但其中的价值还有待进一步挖掘。
时序大模型的出现,对企业来说犹如开启了时序智能的“工业革命”。
所谓时序大模型,即在大规模时序数据上预训练、学习时间变化规律的基础模型。它以按时间排列的数值序列为主要输入,学习趋势、周期和波动等特征,部分模型还能捕捉多个变量之间的关联。
借助时序大模型,企业可以利用自有数据开展趋势预测、异常检测和缺失值填补,为工艺优化、预测性维护等应用提供支持,进而帮助减少非计划停机、降低运维成本、提升生产效率。
值得一提的是,企业通常不必从头开展大规模预训练。基于已有的基础模型,企业可以先评估其在实际场景中的效果,再根据业务需要,利用领域数据继续训练,更好地适应特定领域和业务场景。
但历史记录不会自动变成可用的训练样本。要让这些数据真正参与模型的训练与适配,先要弄清楚:模型究竟需要什么样的训练数据?
海量时序数据,如何成为可用的训练样本?
训练时序大模型,不是“把数据丢给算法”那么简单。
如果数据大量空缺、时间顺序错乱,关键业务信息缺失,哪怕模型训练跑成功,最后出来的结果也很难解释,更不敢直接给到业务用。
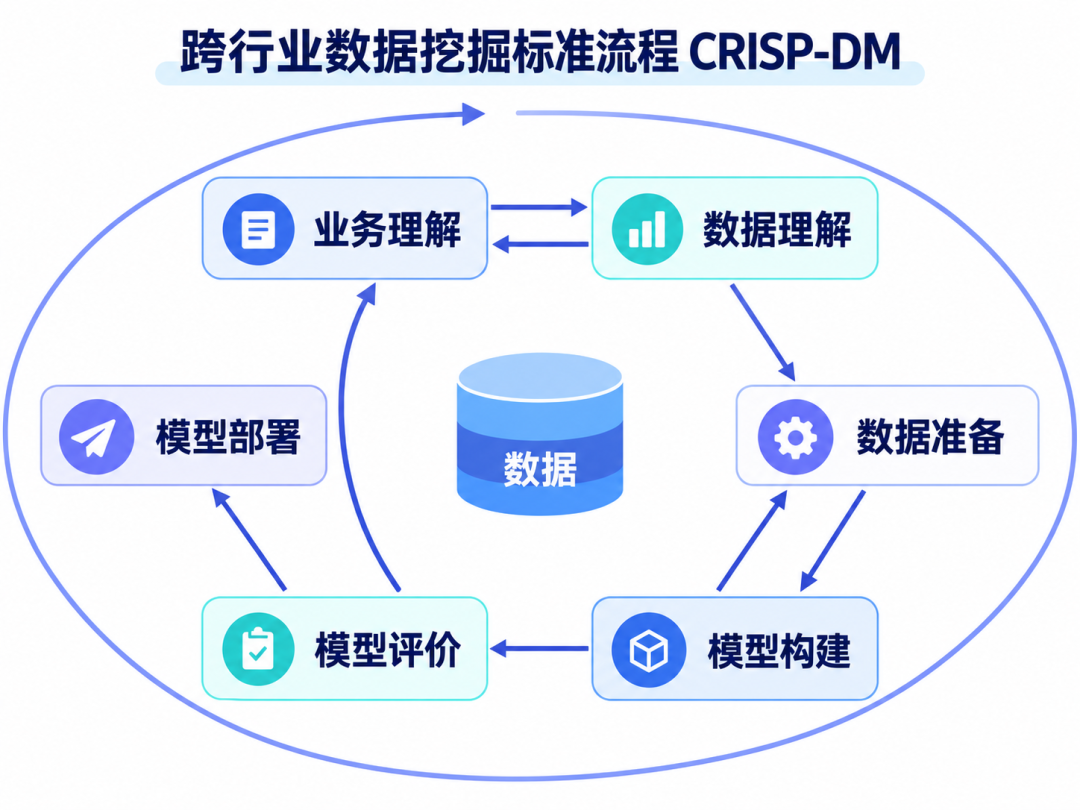
行业里常用的 CRISP-DM 跨行业数据挖掘标准流程,把这件事拆成六步:业务理解、数据理解、数据准备、模型构建、模型评估、部署上线。
想要为模型准备好数据,其中业务理解定方向,数据理解定口径,数据准备定质量。
正因为这个过程的复杂性,数据准备通常需要领域专家、算法工程师和数据工程师等多角色的紧密配合。
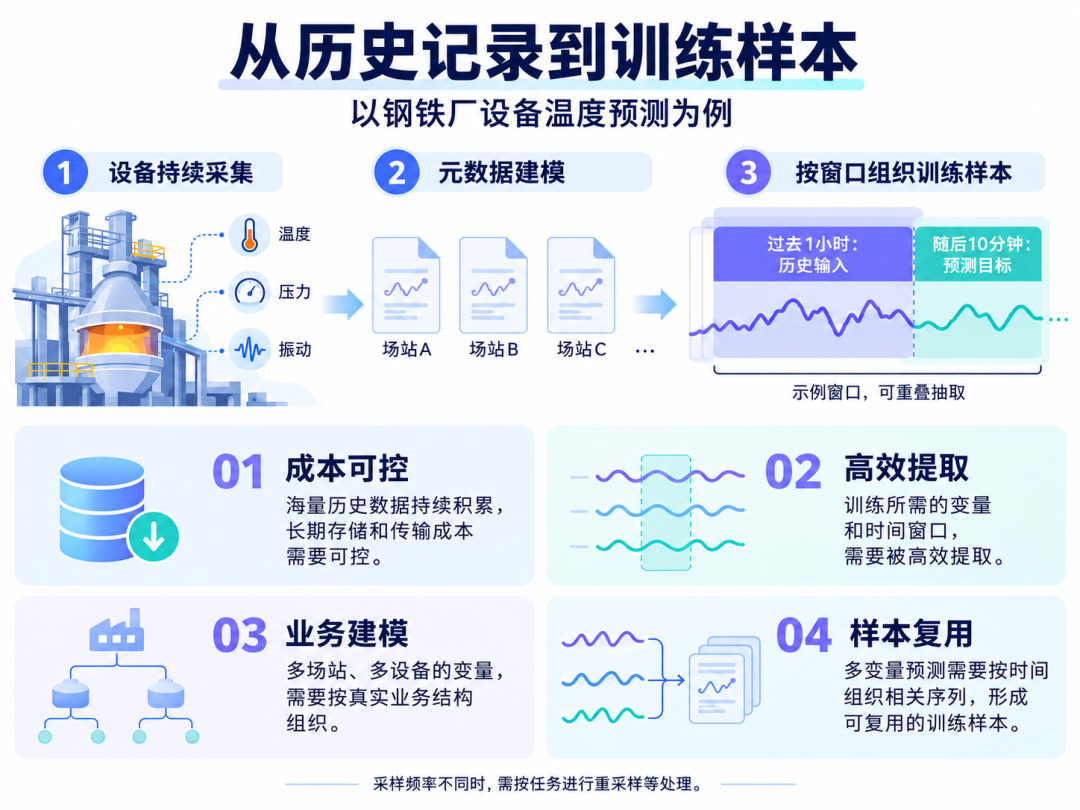
以工厂设备温度预测为例:多台设备持续记录温度、压力、振动等数据,并按设备和日期分别保存。训练时,通常需要从历史序列中抽取连续窗口,例如用过去一小时的数据预测未来十分钟的温度。窗口可以重叠,同一个数据点也可能被多次读取。
这对数据存储与读取提出了四个具体要求:
第一,海量历史数据持续积累,长期存储和传输成本需要可控。让企业能够保留更长时间、更多设备的运行记录,为模型训练积累更丰富的数据基础。
第二,训练所需的变量和时间窗口,需要被高效提取。数据集应支持按所需变量和时间窗口高效读取,减少无关数据的扫描和处理,提高训练数据的供给效率。
第三,多场站、多设备的变量,需要按真实业务结构组织。通过元数据建模,呈现“场站—设备—测点”的 OT 树型层级与归属关系,既能辨认同一设备的不同变量,也能定位不同场站、设备的相关序列,明确训练所需的数据来自哪里、对应什么对象。
第四,多变量预测需要按时间组织相关序列,形成可复用的训练样本。涉及跨设备的相关变量时,也需要按训练窗口提取和对齐,让分散的记录能够共同参与训练,并在不同工具和任务间复用。例如,将温度与同一时段的压力、振动数据联合输入模型;在采样频率不同时按任务进行重采样等处理。
因此,一个更懂时序的格式,成为时序大模型训练链条上必不可少的“基建”。
更懂时序数据的文件格式,做对了什么?
一种“更懂时序”的文件格式,需要怎样的设计,才能帮助企业把历史记录用于模型训练?
可以从两个方面来看:一是存储与计算效率,让海量数据存得更经济、读得更高效;二是数据组织与复用,让分散的记录更容易被识别、组合,并交给不同工具使用。围绕这些需求,IoTDB 团队设计了面向时序数据的文件格式 TsFile。
下面,我们从“存得少、算得快”和“认得清、用得通”两个方面,看看更懂时序数据的文件格式能做到什么。
1.存得少、算得快:为 AI 应用打好数据基础
清华大学软件学院王建民院长把 TsFile 面向时序数据“AI Ready”的价值概括为两点:“存得少”和“算得快”。前者关注数据保存的成本,后者关注数据参与计算与训练的效率。
高压缩,降低长期存储的成本。 工业数据持续积累,时间戳和数值中往往存在可以利用的规律:固定频率采集的时间间隔具有重复性,相邻数值也可能变化不大。TsFile 把时间戳列和数值列分开存储、分开编码——时间戳可采用二阶差分、游程编码等适合周期采集的方案,数值列按数据类型选择编码,再叠加 Snappy 等通用压缩算法,实现高压缩比,降低存储占用。
存储占用降下来,长期历史才可能被保留为训练资产,数据集在团队之间交付、在端边云之间流转时,搬运量也更可控。
“算得快”,则来自数据访问优化与软硬件协同。训练时,模型每次通常只需要特定序列、变量和时间片段。TsFile 利用索引、元数据与统计信息,配合时间过滤和列选择,定位所需数据、跳过无关部分,减少不必要的 I/O 和解码开销。
在此基础上,TsFile 通过批量编解码、多线程并行处理,并在适合的计算路径上利用 SIMD 指令加速,更充分地发挥硬件能力,提高训练数据的供给效率。
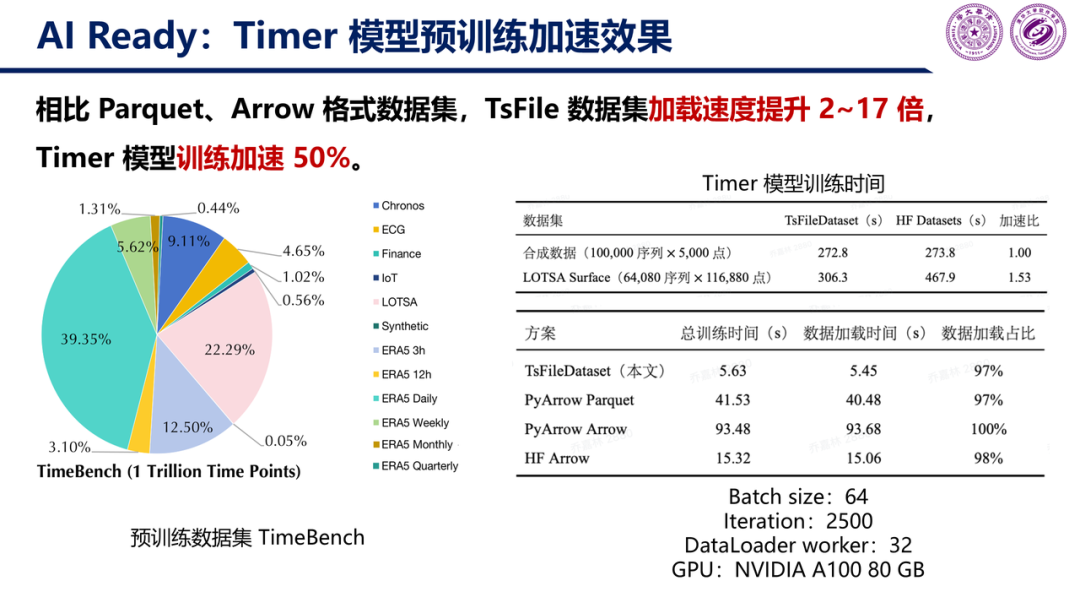
这些设计也体现在实际测试中。在 Timer 模型预训练测试中,相较于 Parquet、Arrow 等格式的数据集,TsFile 数据集加载速度提升 2~17 倍;在大规模 LOTSA Surface 数据集上,相较于 HF Datasets 加载方案,采用 TsFile 的模型训练速度提升约 50%。
2.认得清、用得通:让分散记录成为可访问的数据集
存取效率之外,训练还需要解决数据的识别与组织问题:文件中有哪些序列?字段是什么类型?一个训练窗口跨越多个文件时,如何把它们组合起来?
TsFile 的自描述能力,让文件携带必要的结构信息,读取工具可以据此识别数据,减少对外部约定和人工确认的依赖。至于哪些字段是目标变量、哪些是协变量,仍由具体训练配置定义。
面对分散保存的文件,TsFile 提供了跨文件数据访问工具 TsFileDataFrame,将文件夹中的多个 TsFile 组织为统一的时间序列集合。
训练程序可以按序列和窗口发起读取,由工具协调底层文件访问,按需加载数据。对于多变量任务,它还支持跨文件归并与时间戳对齐,减少上层手工查找、拼接的工作。重采样、缺失值处理等操作,则仍需根据任务要求完成。
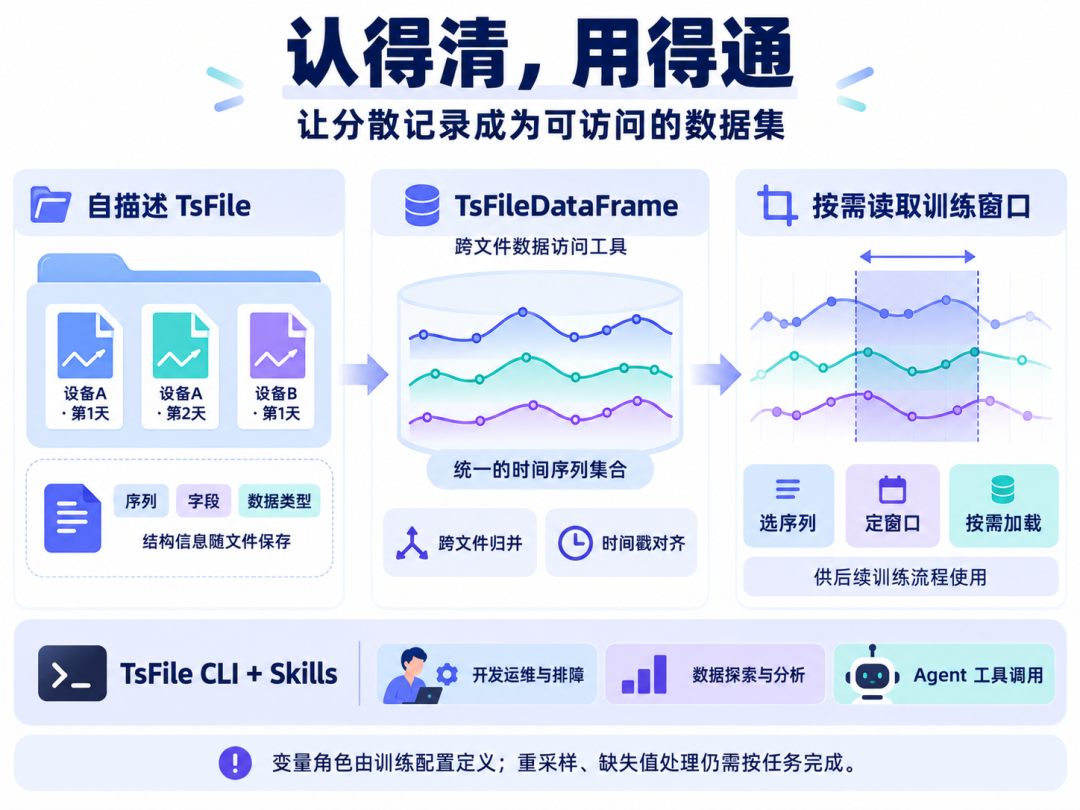
为了进一步降低使用门槛,TsFile CLI 和配套 Skills 能帮助开发者与 Agent 查看、查询和处理数据,已覆盖开发、运维和故障排查、数据探索与分析、AI Agent 的工具调用三大场景。
从高效保存、按需读取,到跨文件组织和跨工具复用,这些能力共同支撑着 TsFile 成为时序数据通用文件格式的目标,也让企业积累的历史记录更顺畅地进入模型训练。
从数据集准备到模型后训练,在 TimechoAI 中落地
TsFile 不只更懂时序数据,也关注使用数据的人对“开箱即用”体验的期待。
TsFile 作为时序数据的“承载者”,其上层还有着完整的工具和生态——目前,TimechoAI 将数据集管理、数据治理与模型后训练衔接起来,进一步降低企业应用时序智能的门槛。
在数据治理阶段,企业需要识别并合理处理影响数据质量的问题:哪些缺失值需要填补,哪些异常点需要修正,哪些波动必须保留,都要结合业务判断。TimechoAI 支持对比治理前后的缺失率、异常点等指标,帮助用户评估加工效果,准备适合训练任务的 TsFile 数据集。
为支持企业构建高质量时序数据集,我们正在探索以独立产品的形式提供数据集管理与治理能力,覆盖从数据质量评估、治理到数据集管理的更完整流程。相关进展将在本公众号分享。
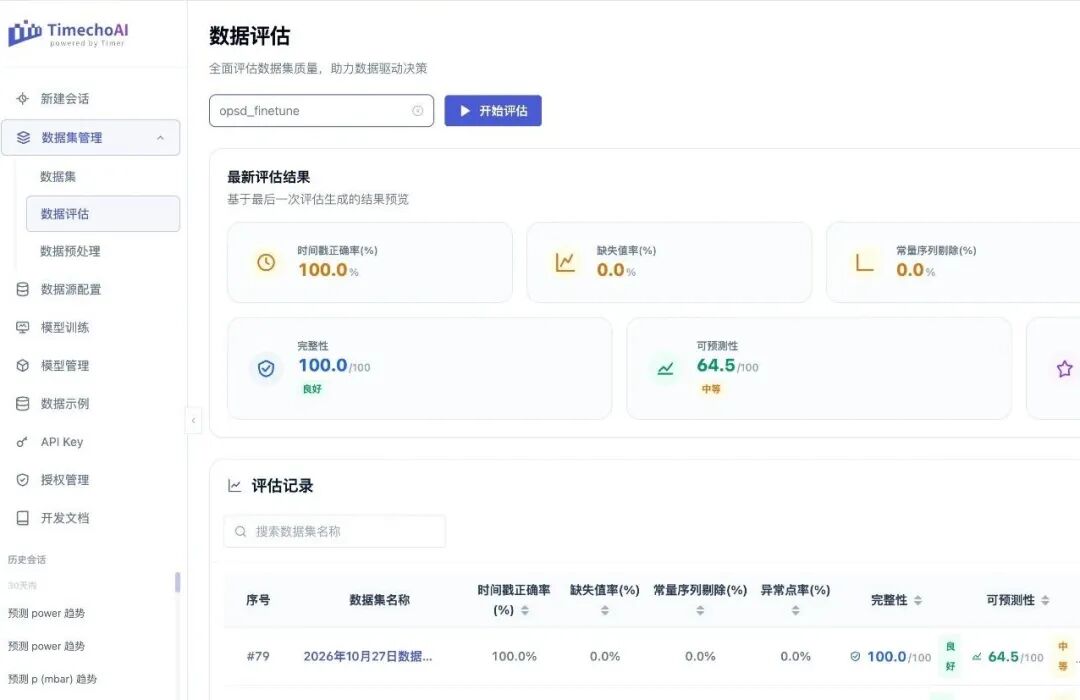
数据准备好后,用户可以在 TsFile 数据集上,基于 Timer 创建后训练任务、设置超参数,并跟踪训练指标与日志。
基于这个思路,TimechoAI 提供领域模型训练和场景模型训练两条路径。
领域模型训练,主要是在基础时序模型上继续训练,让基础时序模型进一步学习特定行业或领域的数据特征,增强模型对领域数据的适应能力;场景模型训练,则更关注具体业务任务,针对某一类预测场景进行适配,结合目标变量、协变量等配置,使模型更好地适配实际业务需求。
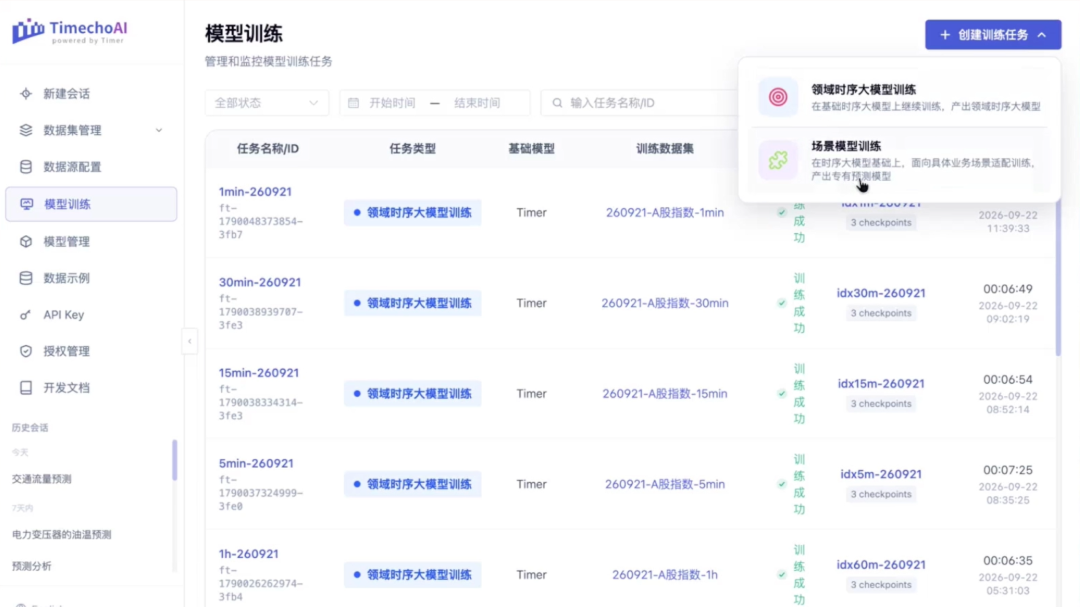
从数据准备到模型适配,TimechoAI 将各环节串成可操作的训练流程。TsFile 则以统一的文件格式承载时序数据,为数据理解、数据准备和模型构建提供支持。
对于训练而言,TsFile 通过压缩降低长期保存和传输的成本,通过自描述让读取工具识别各条序列及其数据类型,这正是“更懂时序”的价值。配合 TsFileDataFrame,训练程序可以按时间窗口跨文件取数、对齐相关变量,既减少人工查找和拼接,也减少无关数据的读取与解码,加快样本加载。
未来,TsFile 将持续完善工具与生态,让同一份时序数据更容易在采集、治理和训练中复用,朝着成为时序数据领域广泛采用的通用文件格式这一目标迈进。
参考文献:
刘星宇, 宋韶旭, 等. Apache TsFile 中的短时间序列分组压缩及合并方法[J]. 软件学报, 2025, 36(3): 941-961. DOI: 10.13328/j.cnki.jos.007277.