


编者按:
在高频、多源、弱网并存的储能场景中,数据平台面临的挑战不只是“把数据存下来”。来自电池簇、PCS、BMS、温控和消防等设备的数据,需要稳定接入、准确组织、快速查询,并进一步服务于调度、控制和运营分析。
在2026时序数据技术创新大会案例分论坛上,数字化平台架构师华冬进以“接、管、用、迁”为主线,分享了团队使用 IoTDB 支撑储能数据全链路的实践,演讲从边缘网关上报讲到云端查询与控制,并复盘了约10TB历史数据的集群迁移。
一、先看问题,储能数据为什么难
储能站单站测点数通常可达1500至2000个,大型储能站甚至包含超过10万颗电芯。遥测数据一般按5至10秒的频率变化,部分数据达到毫秒级;遥信数据则需要在状态变位后快速上送。
与此同时,站端数据往往通过4G流量卡传输,公网链路可能出现拥塞、抖动和中断。数据一旦丢失,不仅影响运行监视,也可能影响调度执行、工商业储能收益和设备安全,因此系统既要接得住高频、多源数据,也要在弱网环境中尽量保持数据完整。
二、从业务结构出发选择IoTDB
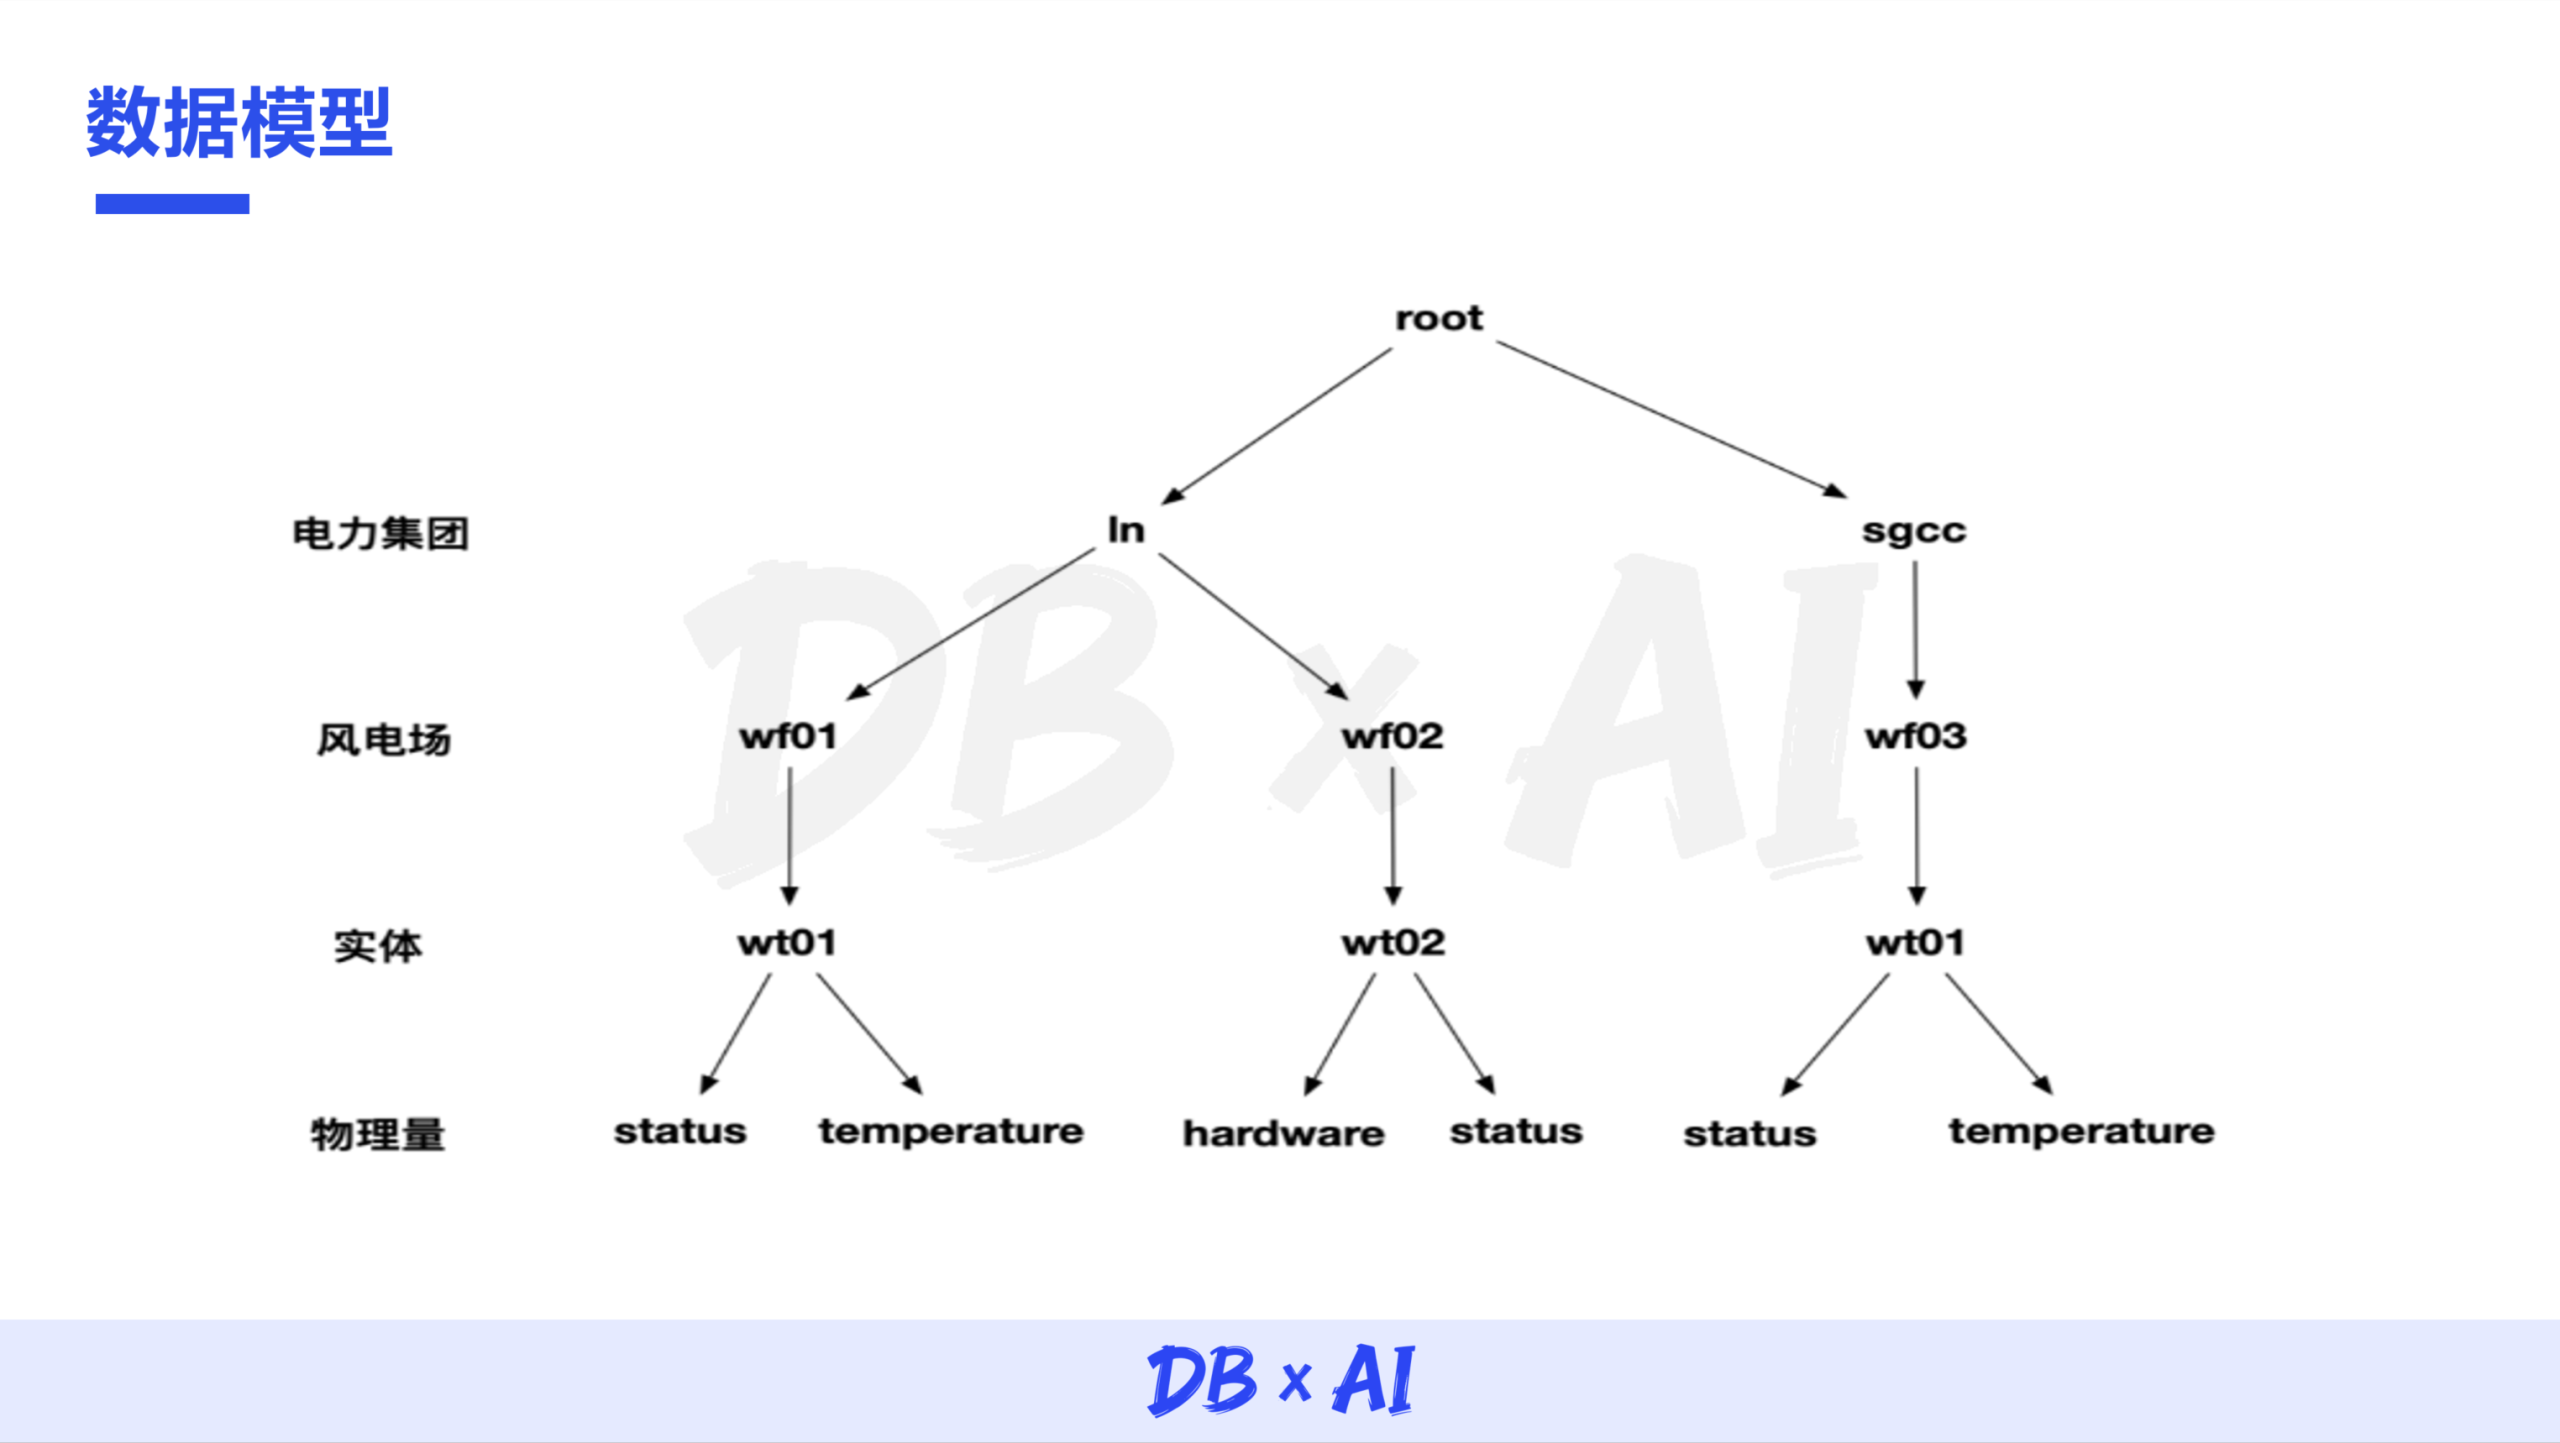
据华冬进介绍,团队在选型前进行了约两至三个月的技术调研与场景验证。此前,他们曾尝试 MongoDB 、商业实时数据库等不同方案,但在查询性能、数据存储规模及降采样效率等方面均遇到过不同挑战。最终,IoTDB 树模型与储能场站的设备层级结构较为契合,能够按照站点、设备、测点等业务层级组织时序数据,减少数据模型与实际设备结构之间的适配成本。
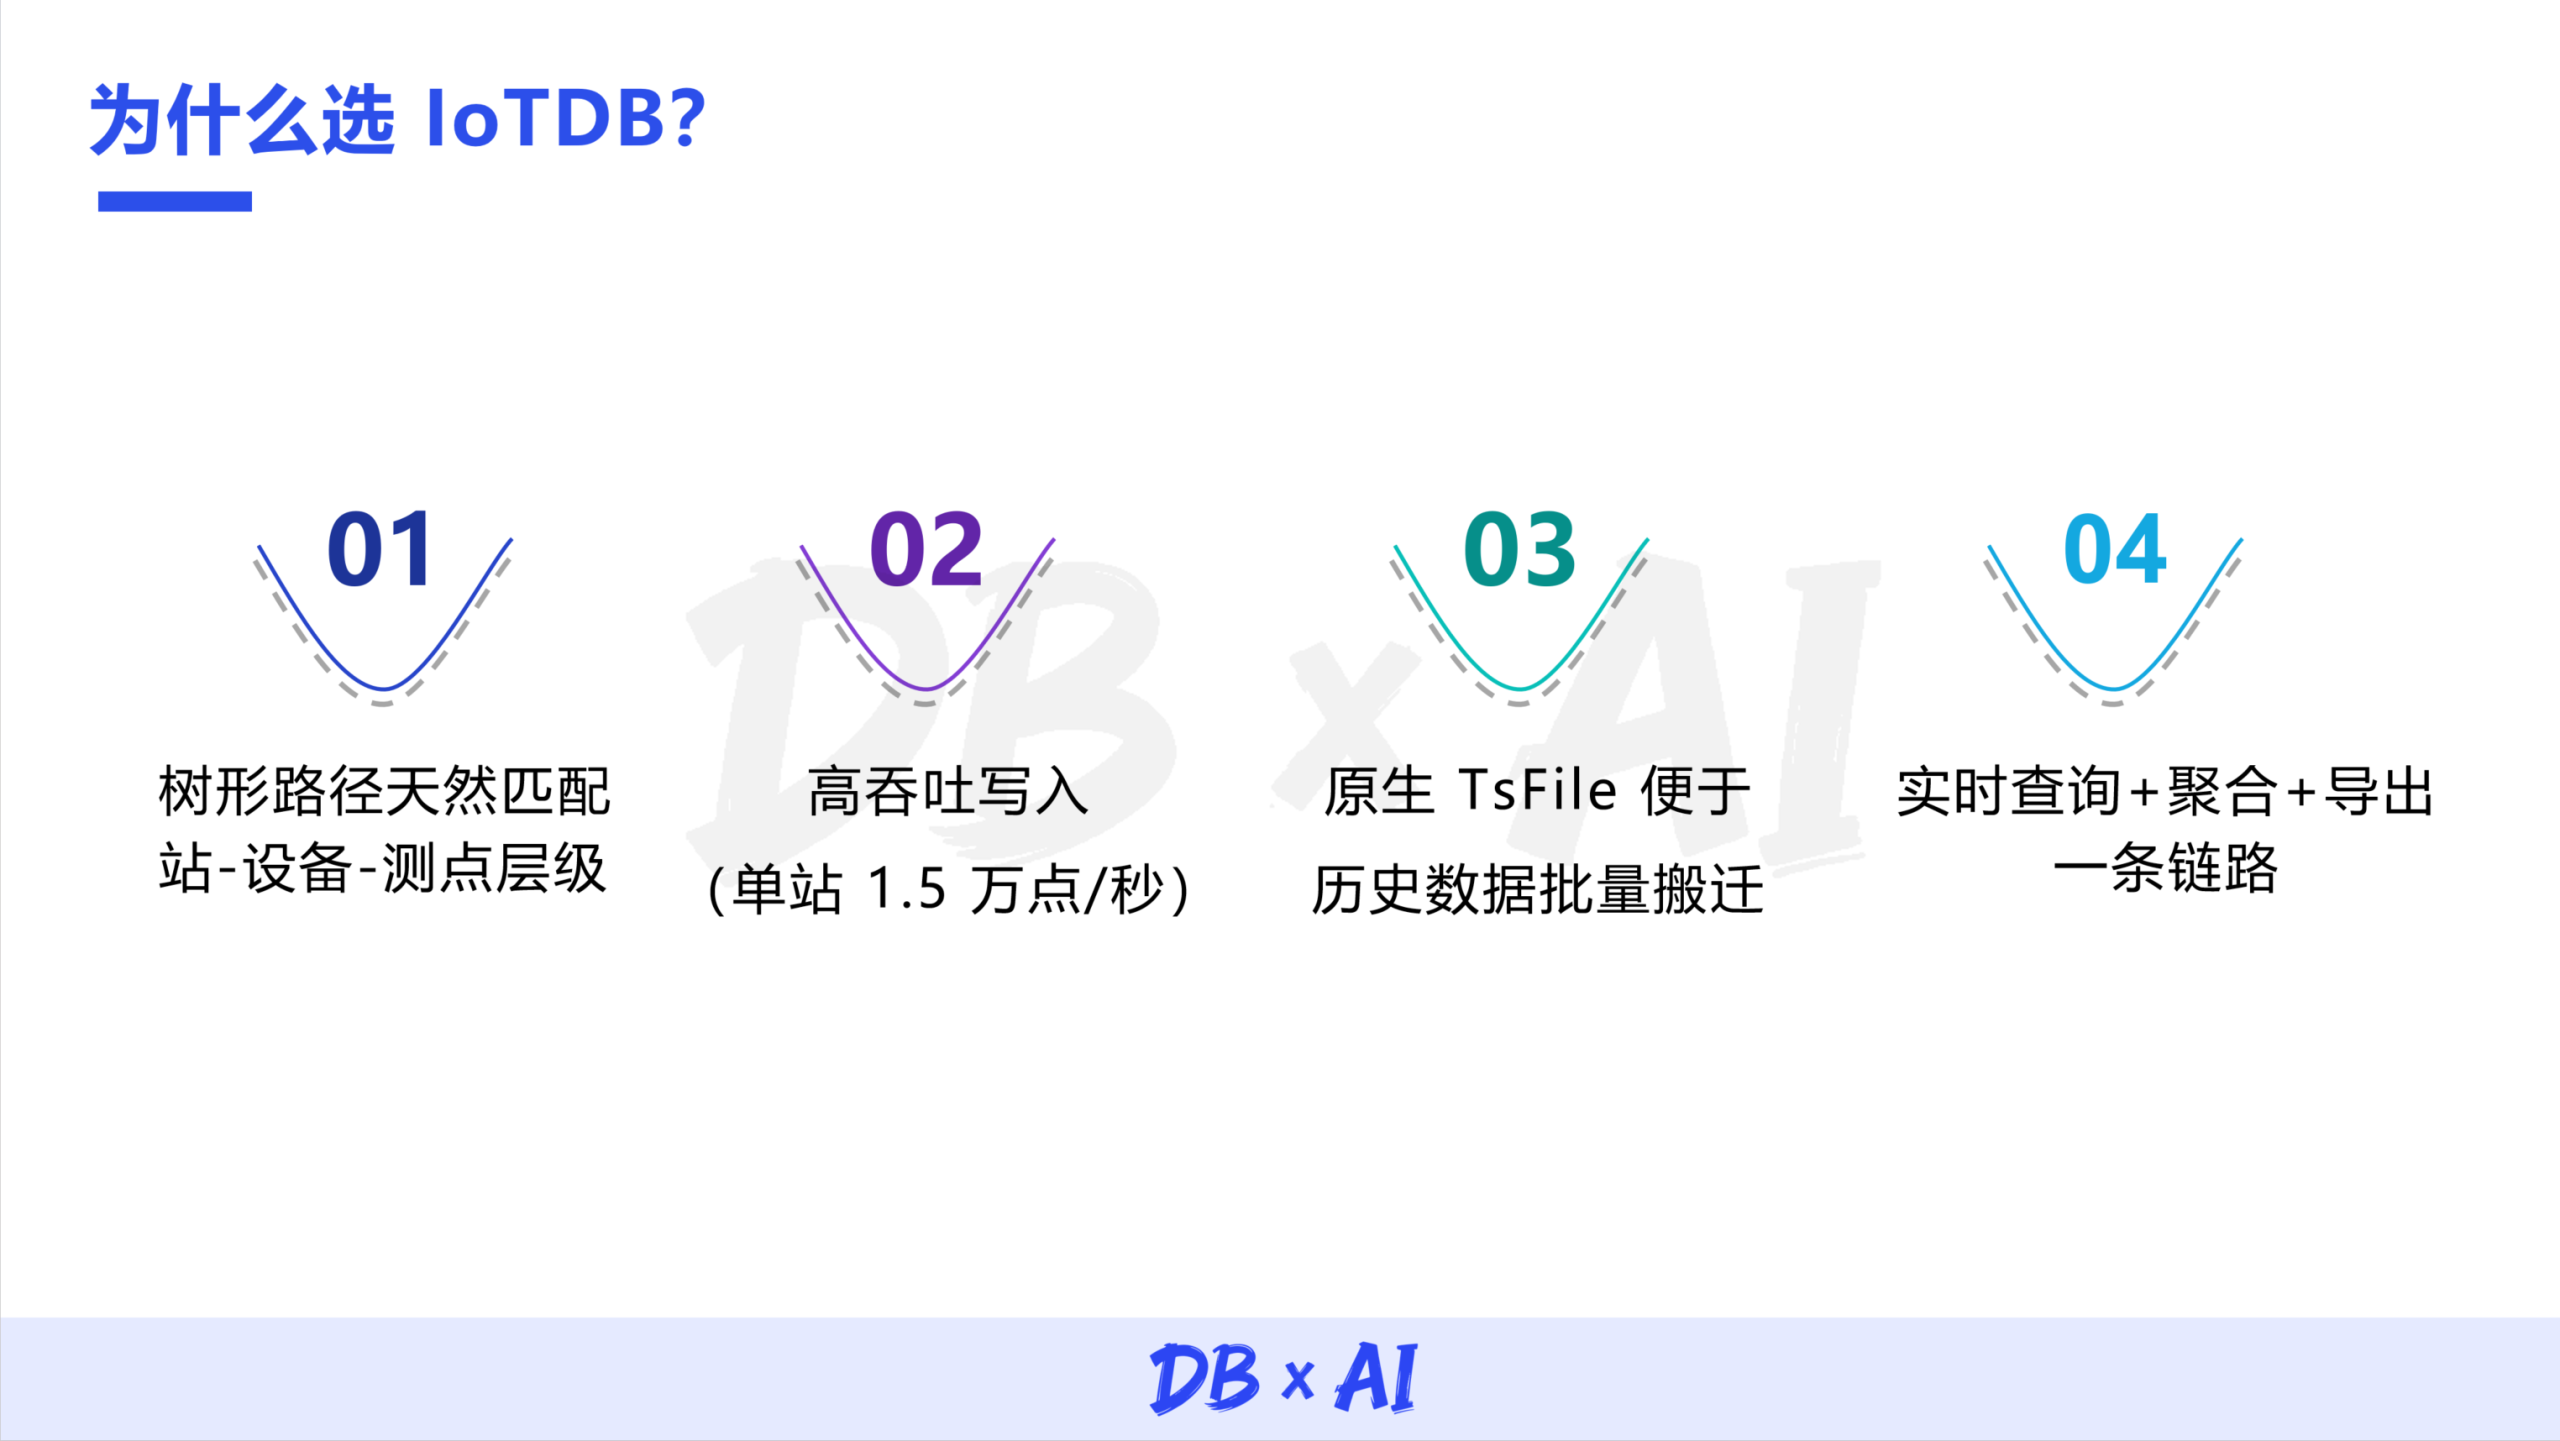
写入吞吐能力、实时查询性能以及 TsFile 原生文件格式,同样是团队选型时的重要考量。华冬进表示,在写入吞吐方面,在实际应用中,IoTDB 能够支撑单站至少1.5万点/秒的写入需求;在高配置硬件及特定数据迁移场景下,团队还观察到了千万级点/秒的写入能力。报告中分享的集群监控数据表明,系统日常写入吞吐已达到每秒10万点量级。与此同时,IoTDB 原生支持的TsFile格式及其批量加载能力,也为后续 TB 级历史数据迁移提供了重要基础。
这次选型 IoTDB 并不是只比较某一项性能指标,而是综合评估数据模型、写入路径、查询能力和数据生命周期管理是否适合储能业务。
三、接入先解决弱网,再谈高吞吐
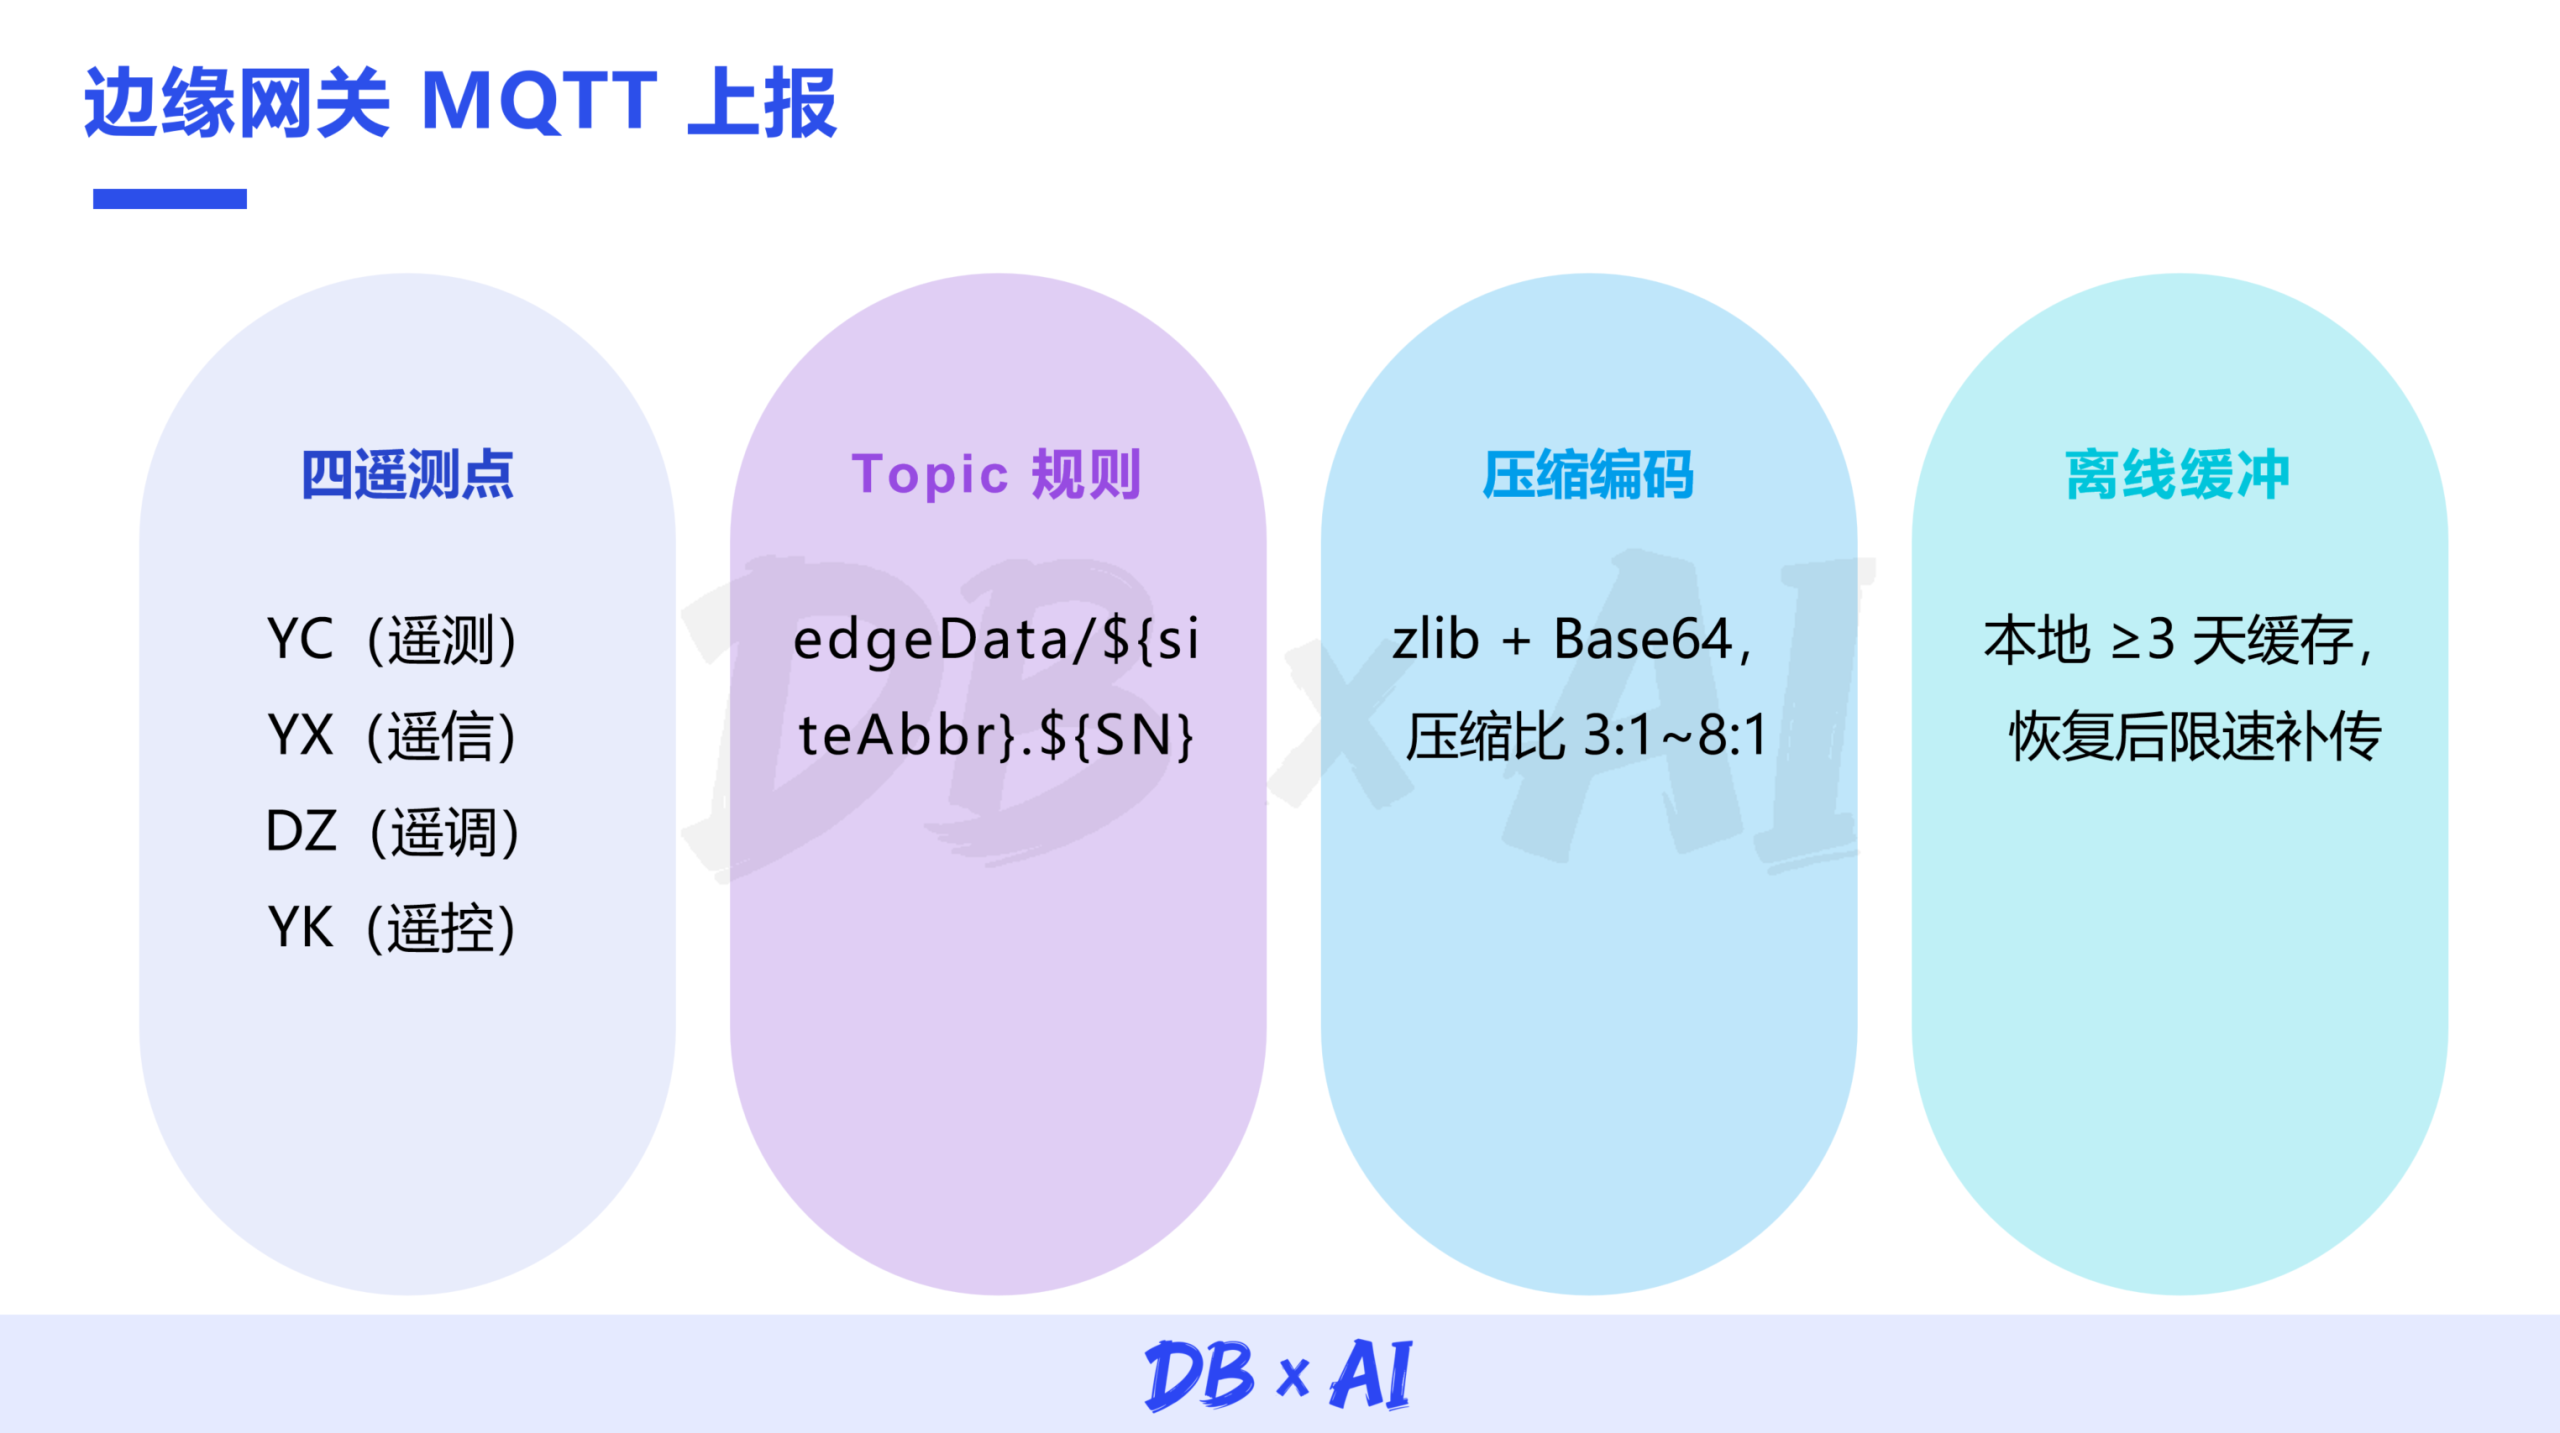
在数据采集链路上,站端网关主要通过 MQTT 上送遥测、遥信等设备数据,云端则通过相应链路下发遥控、遥调等指令。团队在 MQTT Topic 中约定站点编码与设备 SN 等信息,以区分不同场站、不同设备的数据来源。
对于上送的数据,站端采用 zlib 与 Base64 进行压缩编码在站端能做到不少于三天的本地缓存,方便公网链路恢复后,再对未上传数据限速补传。
根据方案介绍,这套设计首先解决弱网环境下的数据连续性问题。网络暂时中断时,数据留在站端;链路恢复后再有序补传,避免集中上传进一步挤占带宽。压缩编码则减少传输与本地存储压力。
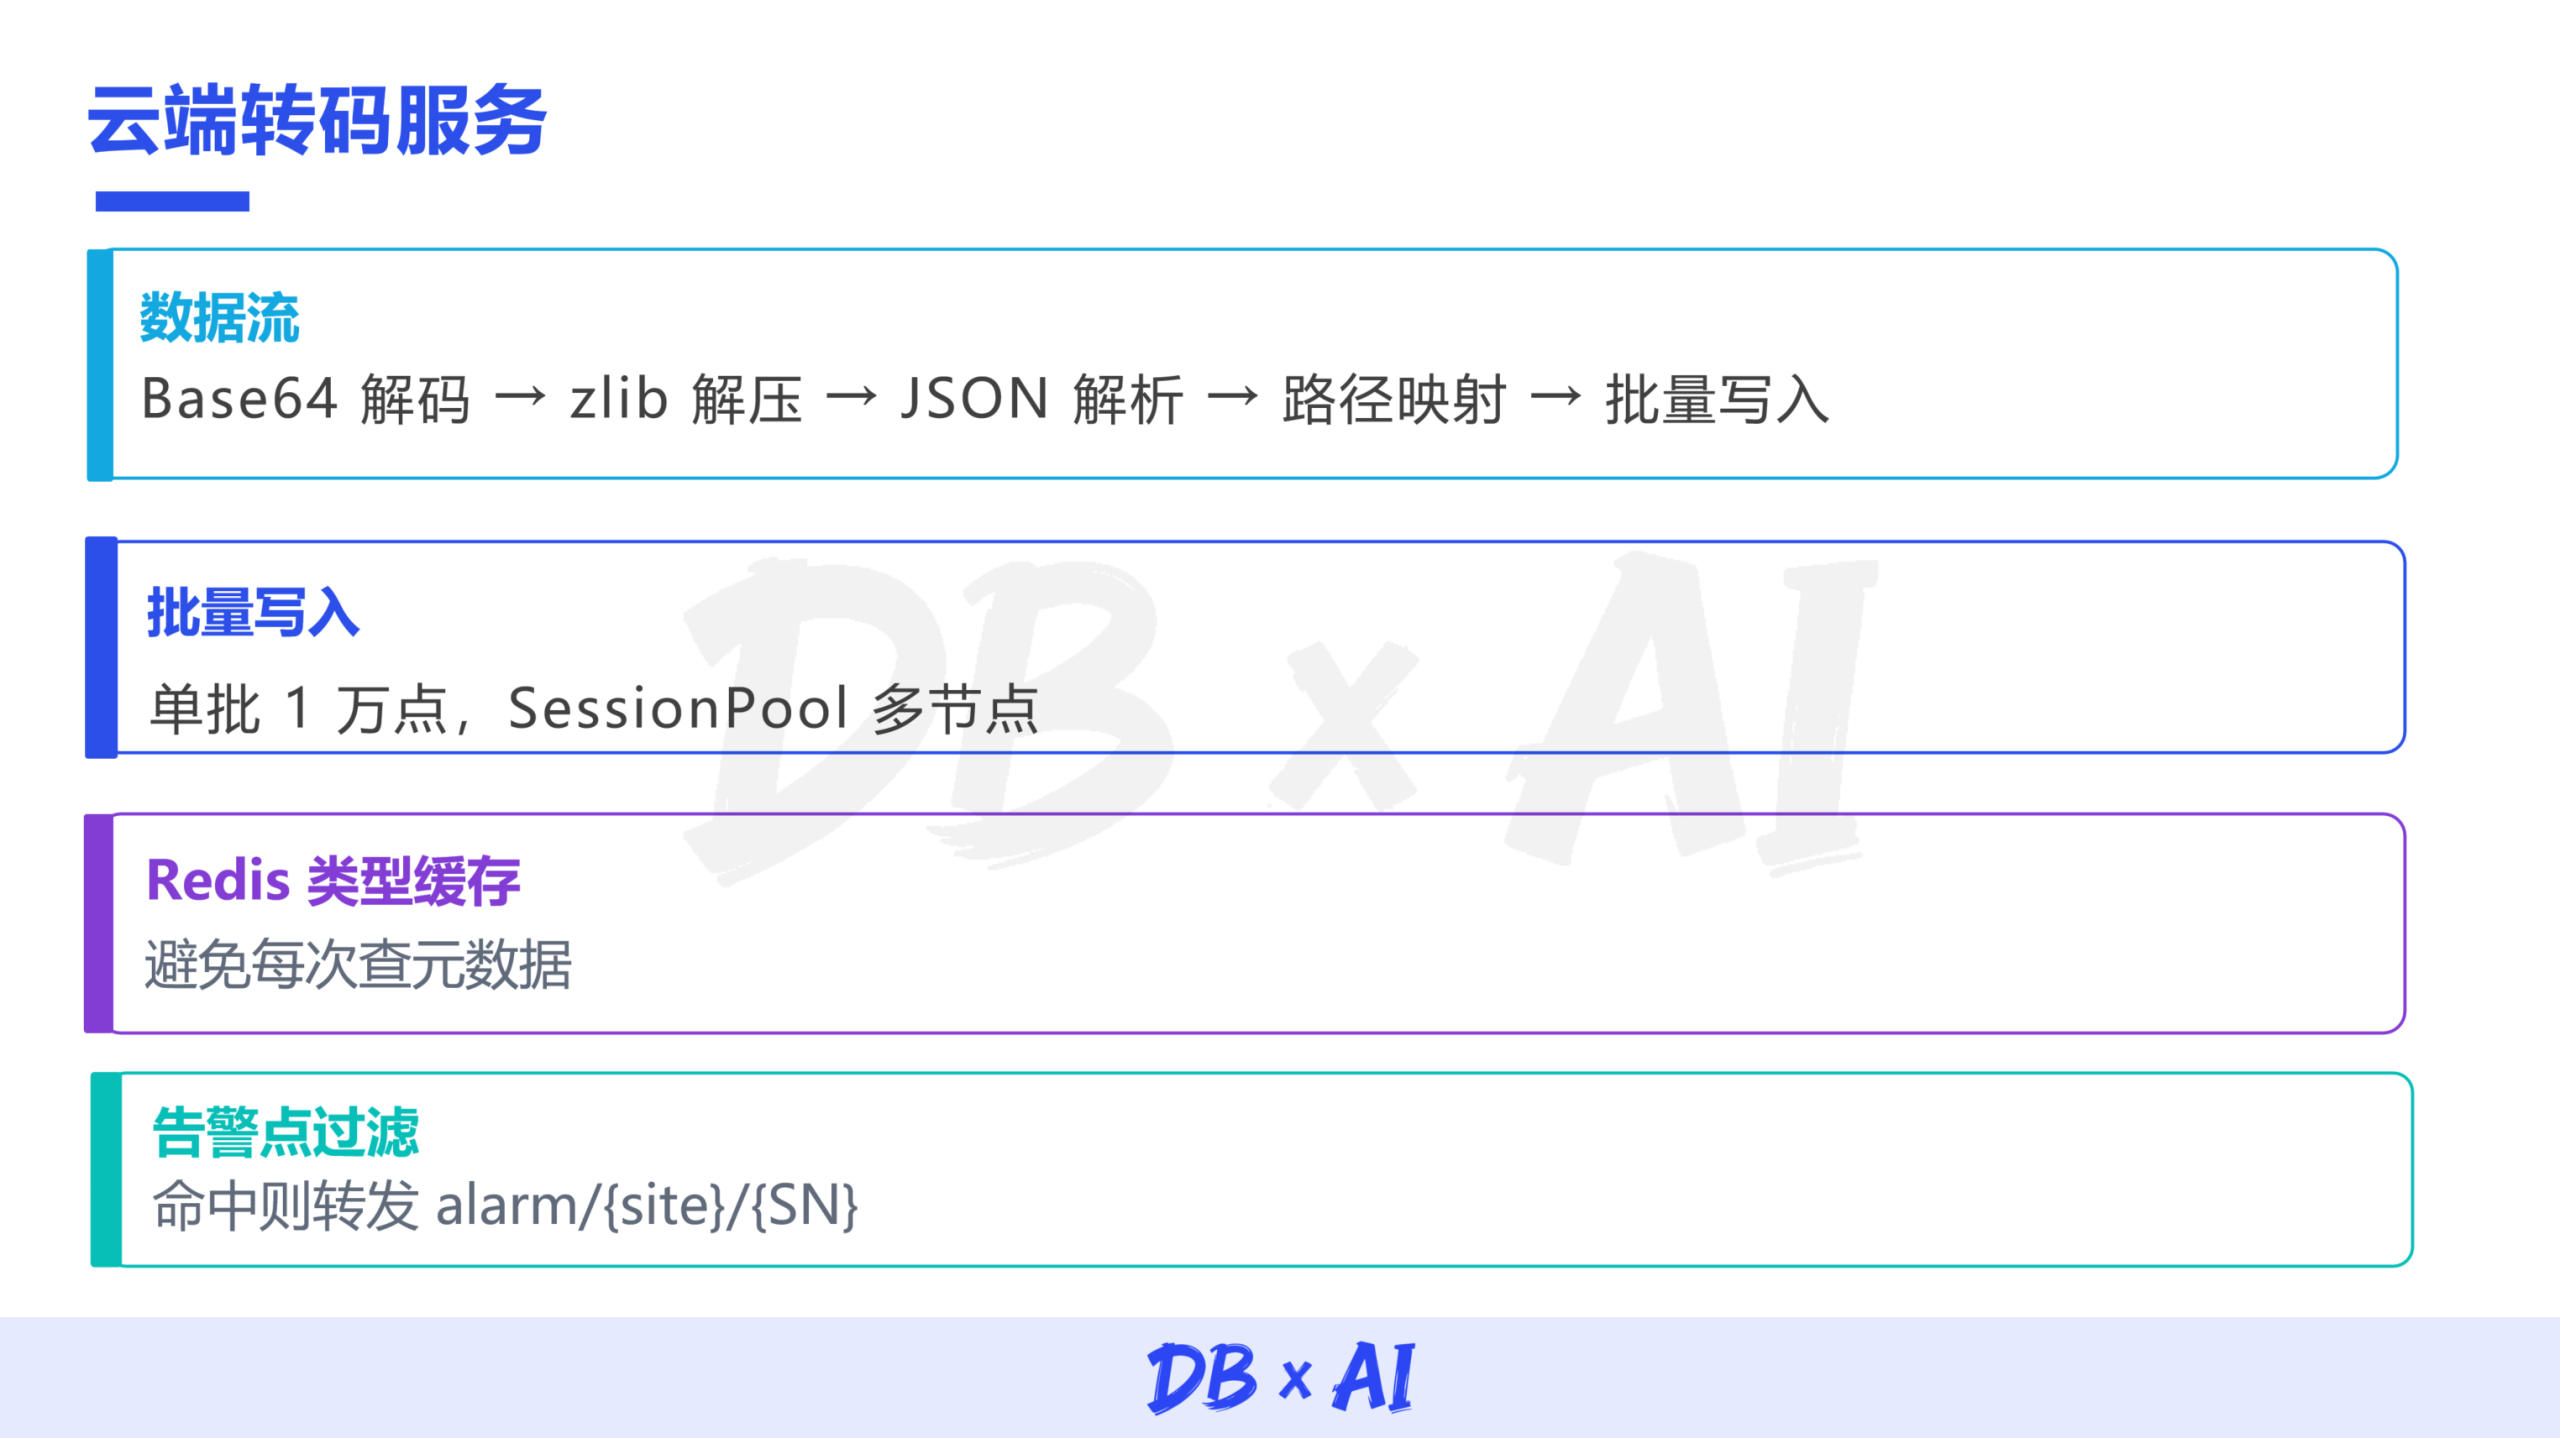
据华冬进介绍,数据到达云端后,转码服务完成 Base64 解码、zlib 解压、JSON 解析、路径映射和批量写入。团队没有逐条写库,而是通过 SessionPool 连接多个节点,累计到单批1万点后再写入 IoTDB,以减少逐点写入造成的请求开销。业务属性与站端测点之间的映射信息放入 Redis,避免反复查询关系型数据库;告警测点则按照 Topic 规则转发到告警服务。
演讲中还提到,团队还对 IoTDB 原生 PayloadFormatter 插件和 SessionPool API 进行了实际测试,并结合现场数据规模、写入频率和服务部署方式,对比发现,前者的写入效率未能满足实际需求,因此团队经过多轮测试及与天谋科技技术人员的交流,最终采用 SessionPool 批量写入方案。这个选择来自真实业务压力下的验证,体现了 IoTDB API 与工程架构的适配空间。这也说明,数据库提供多种接入方式后,仍需要结合业务数据规模和部署架构进行实际验证。
四、查询与控制,让数据真正进入业务
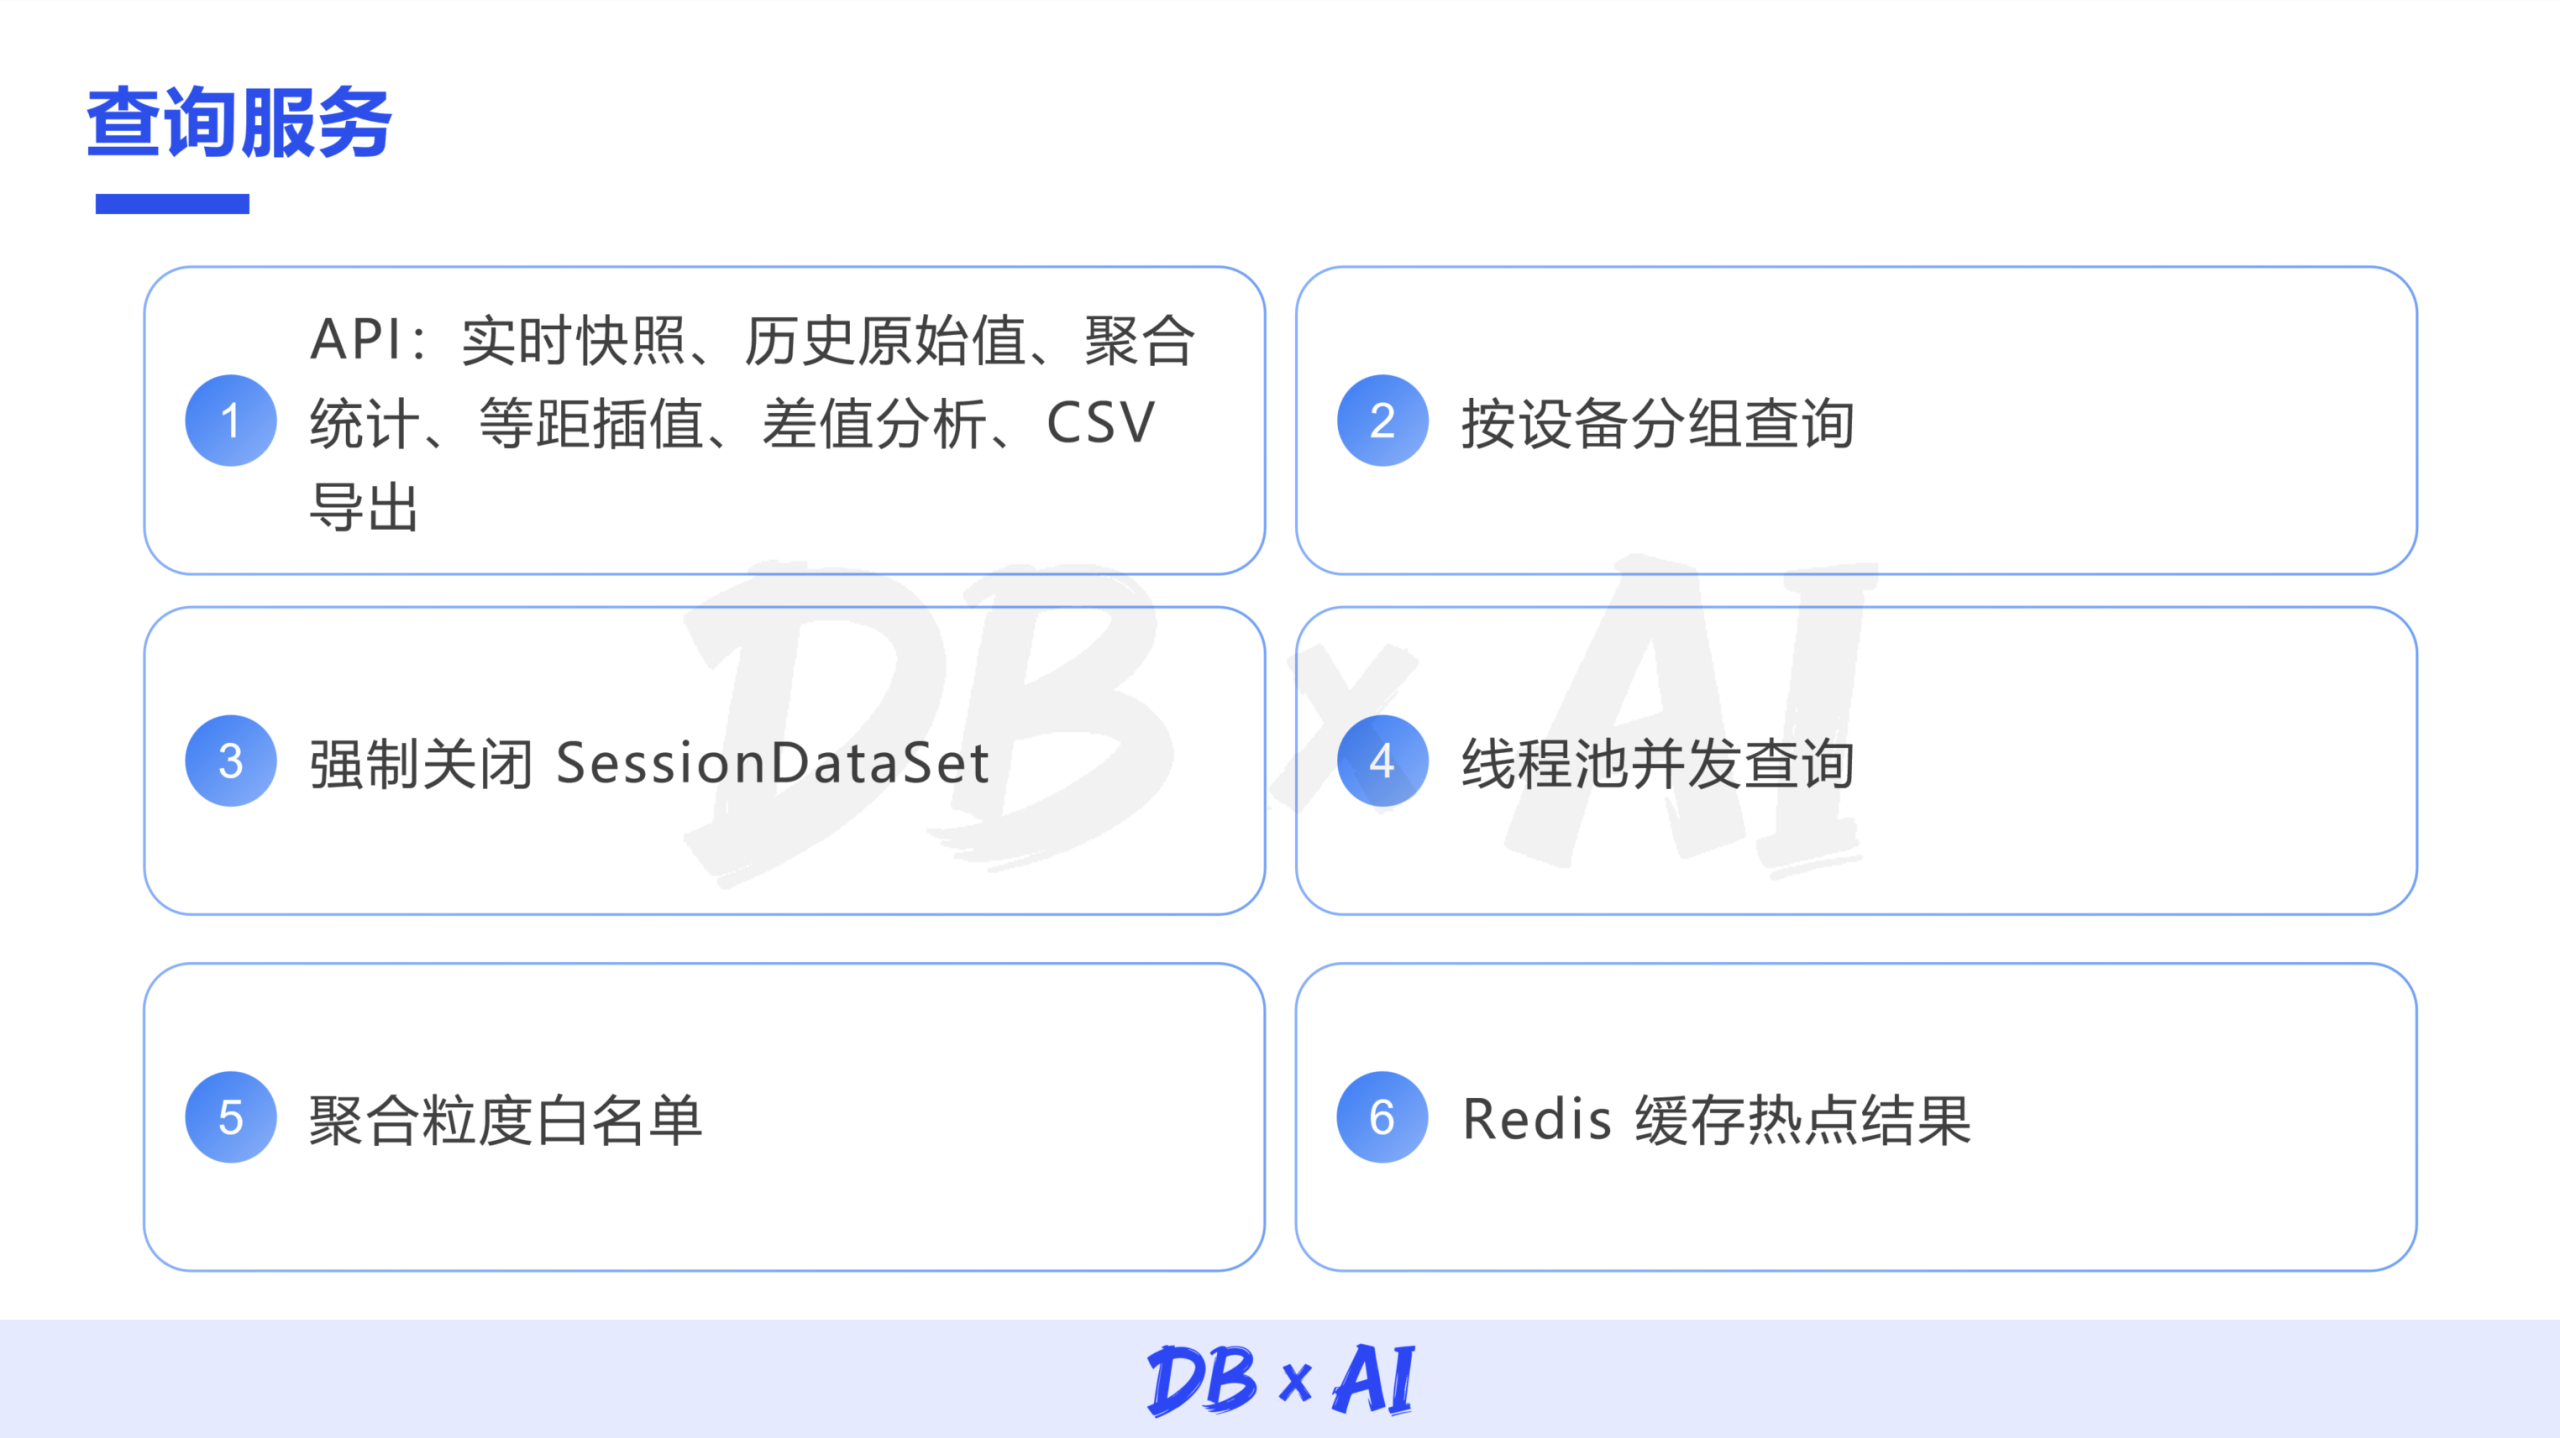
华冬进表示,数据进入 IoTDB 之后,平台不仅要“看数据”,还要让数据参与业务运行。查询服务面向云端平台,通过开放 API 对外提供数据,能力包括实时快照、历史原始值、聚合统计、等距插值、差值分析和 CSV 导出,并支持按设备分组查询。
同时,高并发查询的稳定性还需要应用层配合。团队强制关闭 SessionDataSet,避免连接泄露;通过线程池执行并发查询;对允许使用的聚合粒度设置白名单;对分钟、小时、天、月、年等已经固化的热点结果进行落盘或缓存,减少重复聚合。云平台由此能够查看站级、设备级乃至电芯级的实时与历史数据,并支持原始采集值、拟合值的查询与导出。
在控制链路中,团队建立了指令下发与回执确认机制,要求每条控制指令都有对应反馈。对于包含多个点位的功率计划等批量控制任务,系统采用严格的整体成功判定规则:只要其中一个点位下发失败,就将该组任务判定为失败,避免将部分执行成功的计划误判为全部成功。
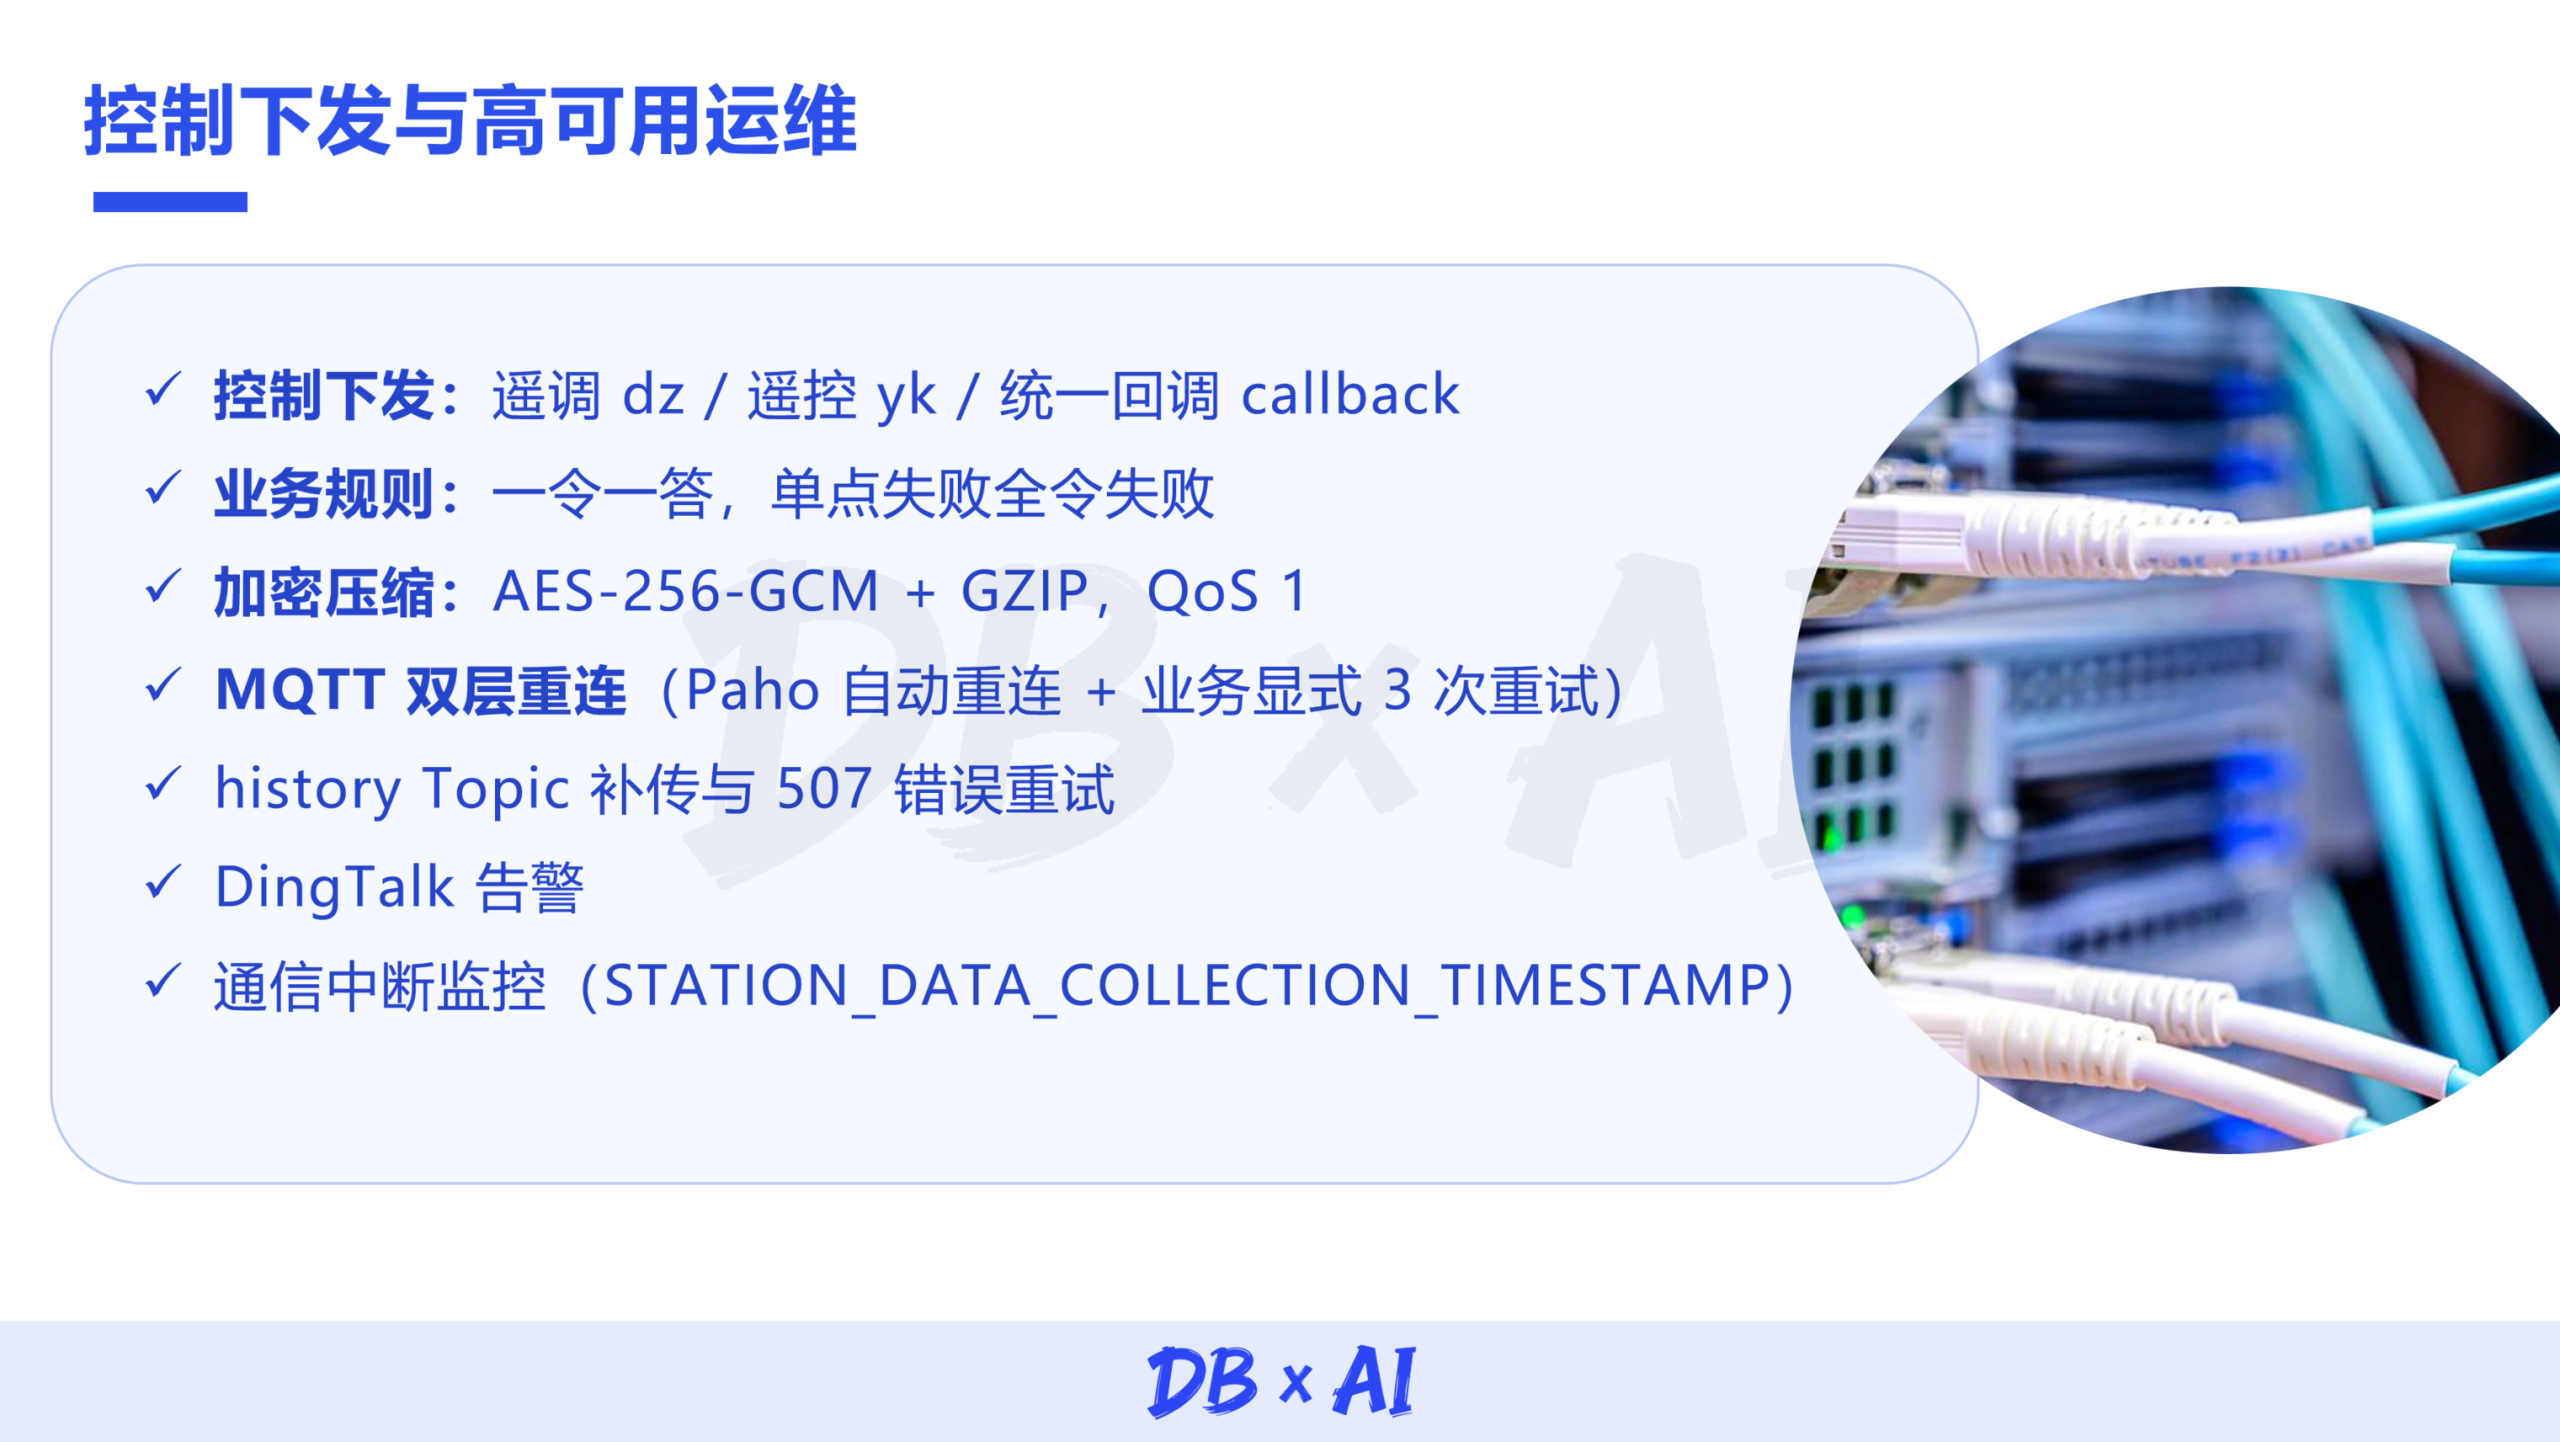
华冬进介绍,系统还通过指令加密、压缩、MQTT QoS 配置、自动重连和业务层显式重试等措施,提高弱网条件下控制指令传递的可靠性。对于自动执行的功率策略,一旦发生通信异常或下发失败,平台还可通过钉钉向运维人员发送告警。
由此,数据平台从单向采集扩展为查询与控制双向联动。
五、迁移不是简单的文件拷贝,而是全链路验证
华冬进在演讲中还分享了一次因公司整体搬迁而开展的 IDC 机房迁移实践。
由于原机房预计存在约20天的停机窗口,团队需要在保证储能站端数据持续接入的同时,完成原有 IoTDB 集群的迁移。当时,原集群采用3个 ConfigNode、3个 DataNode 的单副本部署架构(3C3D),待迁移数据接近10TB,包含约400亿个时序点。
为保障迁移期间新增数据的接入,团队先把站端数据上传地址切换到公有云,由公有云环境临时承接新数据;新机房准备完成后,待新机房及 SSD 存储集群准备就绪后,再将相关历史数据和迁移期间产生的数据导入新环境。
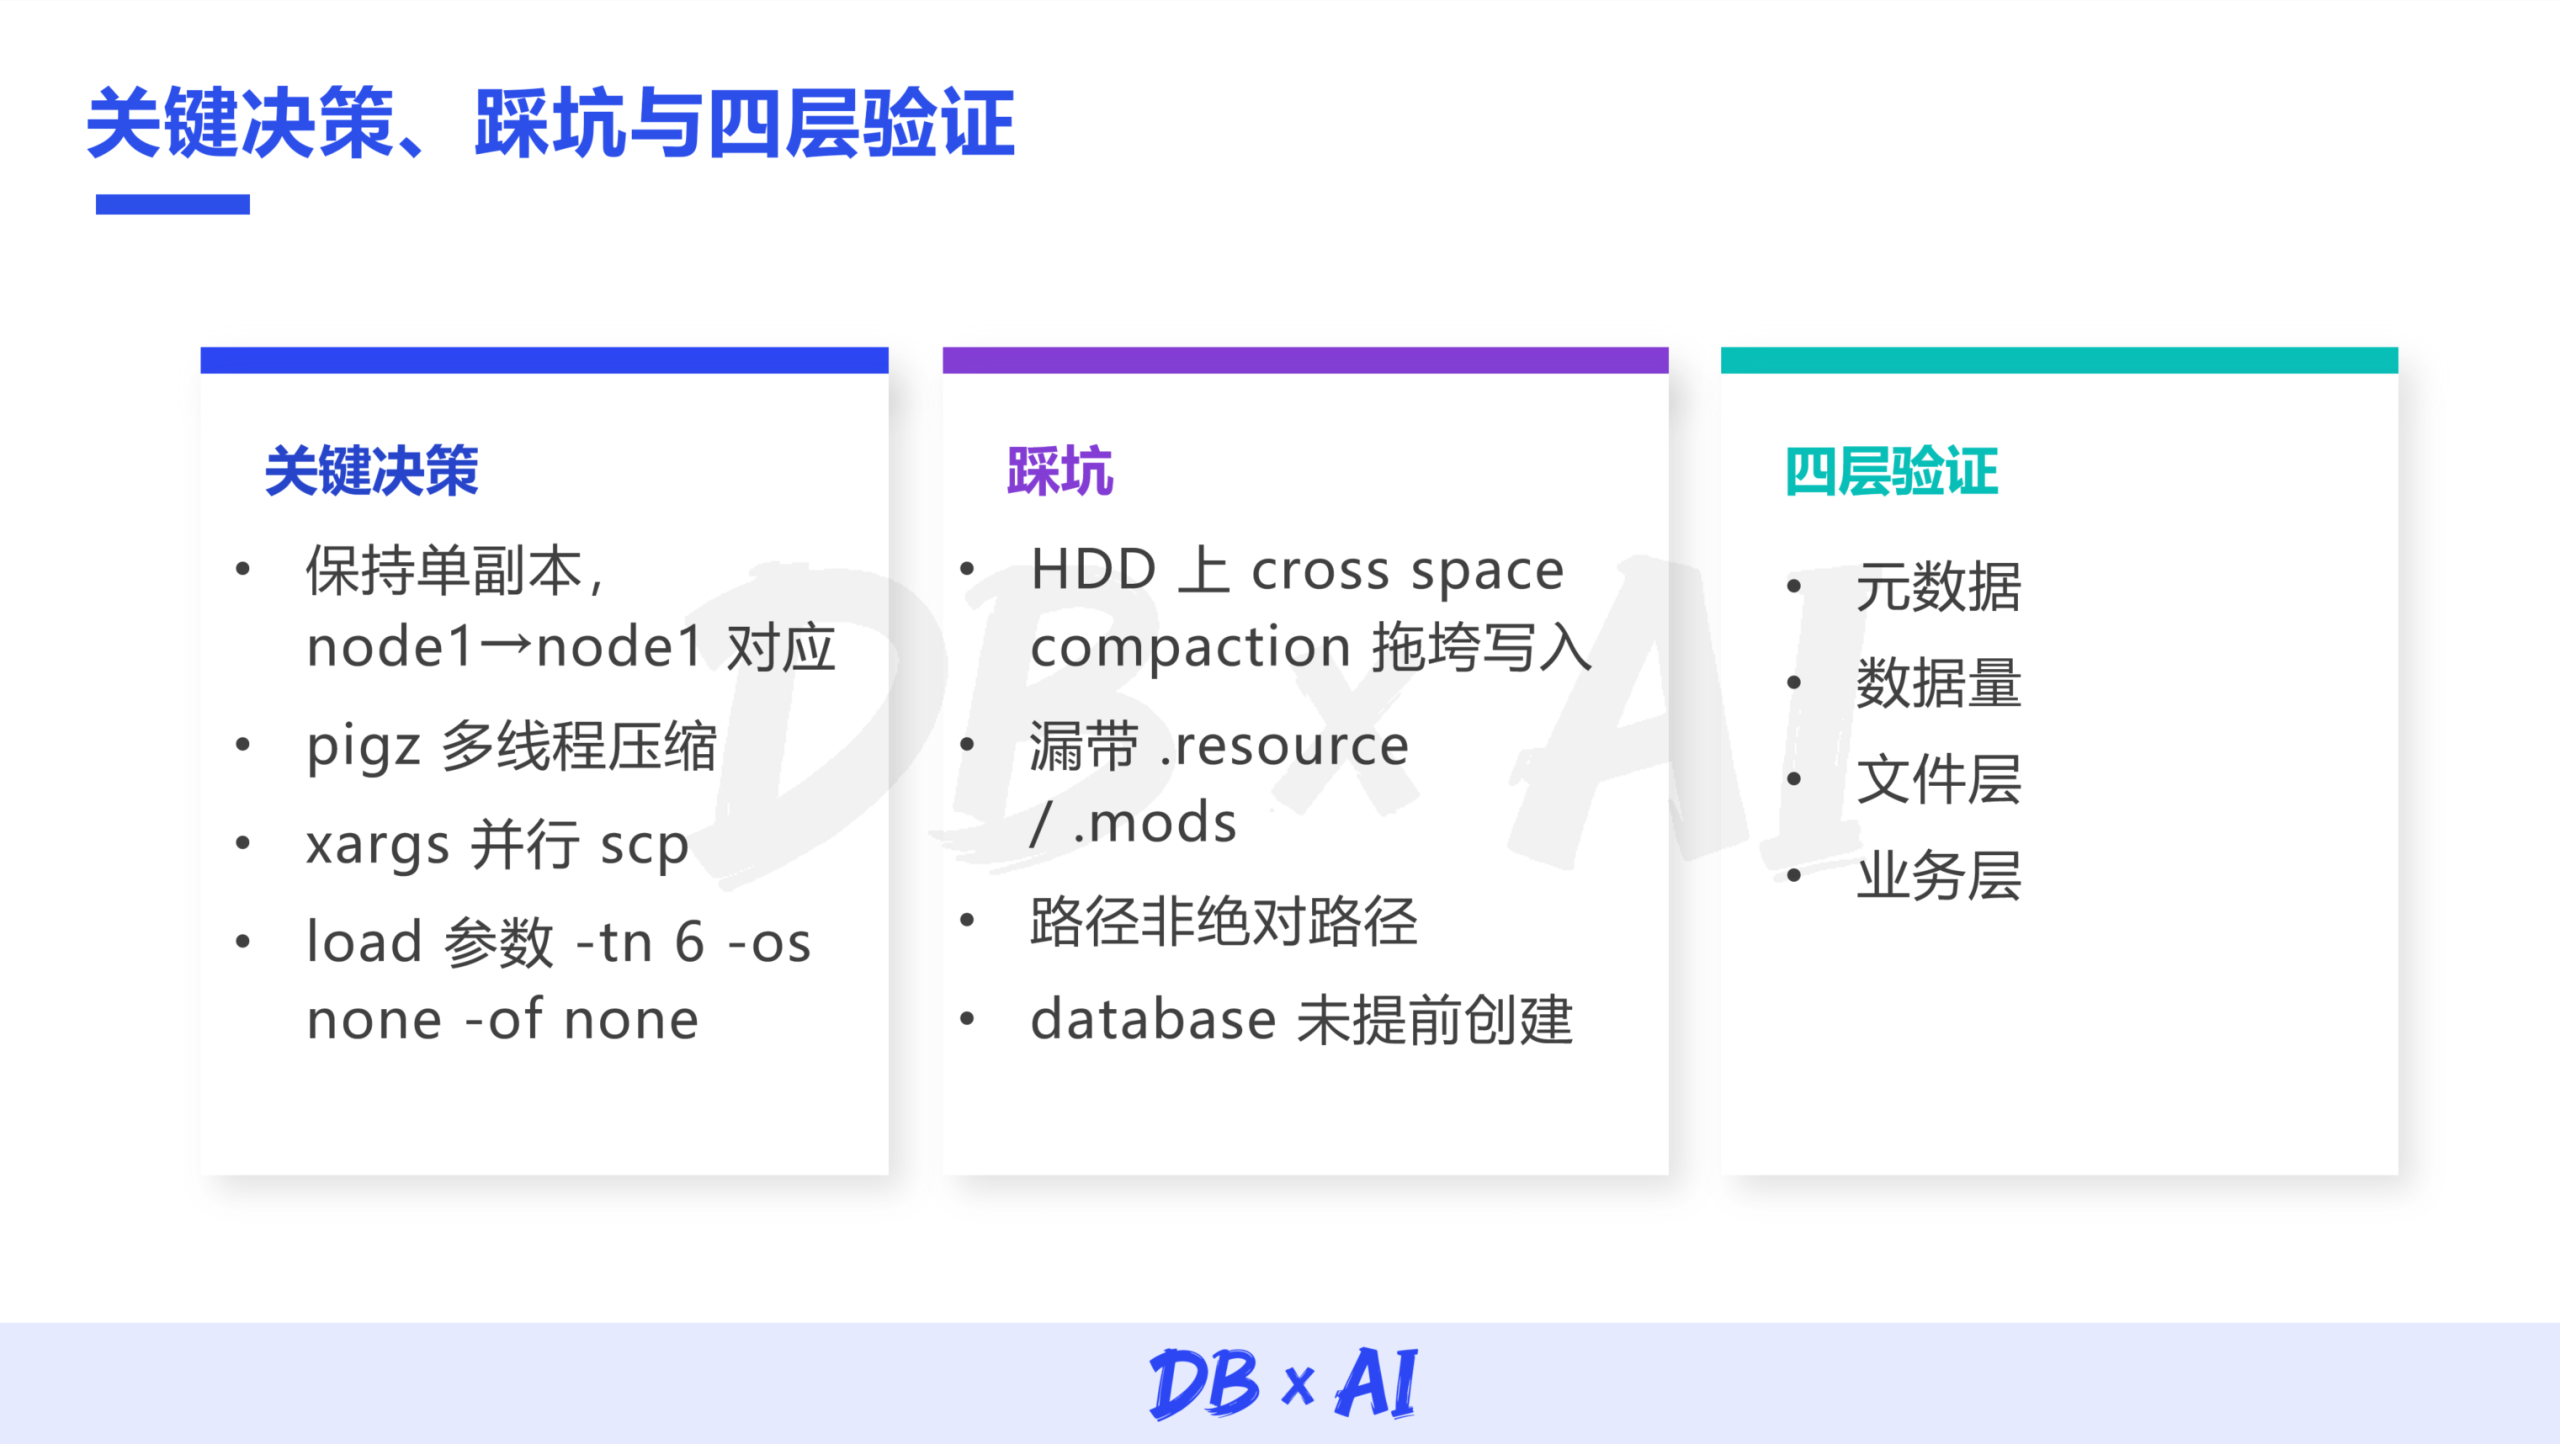
面对这一规模的数据,团队围绕迁移效率、数据完整性和实施窗口进行方案评估,最终采用按 TsFile 搬迁的方式,保留索引和压缩信息,并维持原版本、单副本及 DataNode 的一一对应关系。TsFile 在本项目中承担的不只是文件存储功能,也成为可执行的历史数据搬迁路径。
在传输环节,团队使用 pigz 多线程压缩和并行拷贝,数据落盘后再通过 load-tsfile 加载。为了避免海量成功与失败日志占用空间,团队另外编写脚本记录加载失败信息,以便迁移结束后复核。
迁移实施中,团队也总结了若干容易忽视的操作细节:存储介质的读写性能会直接影响压缩和搬迁效率;除 TsFile 数据文件外,还需根据原集群版本及数据状态妥善处理相关的 .resource 资源文件和 .mods 修改文件;在执行批量加载时,应正确设置文件绝对路径,并提前创建目标数据库。
华冬进介绍,迁移完成后,团队从元数据、数据量、文件层和业务层进行四层验证,结果显示历史数据完整迁入,没有出现数据点丢失。
六、总结,四个可复用的工程方法
结合华冬进的分享,可以将这套实践归纳为四个可复用的工程方法。
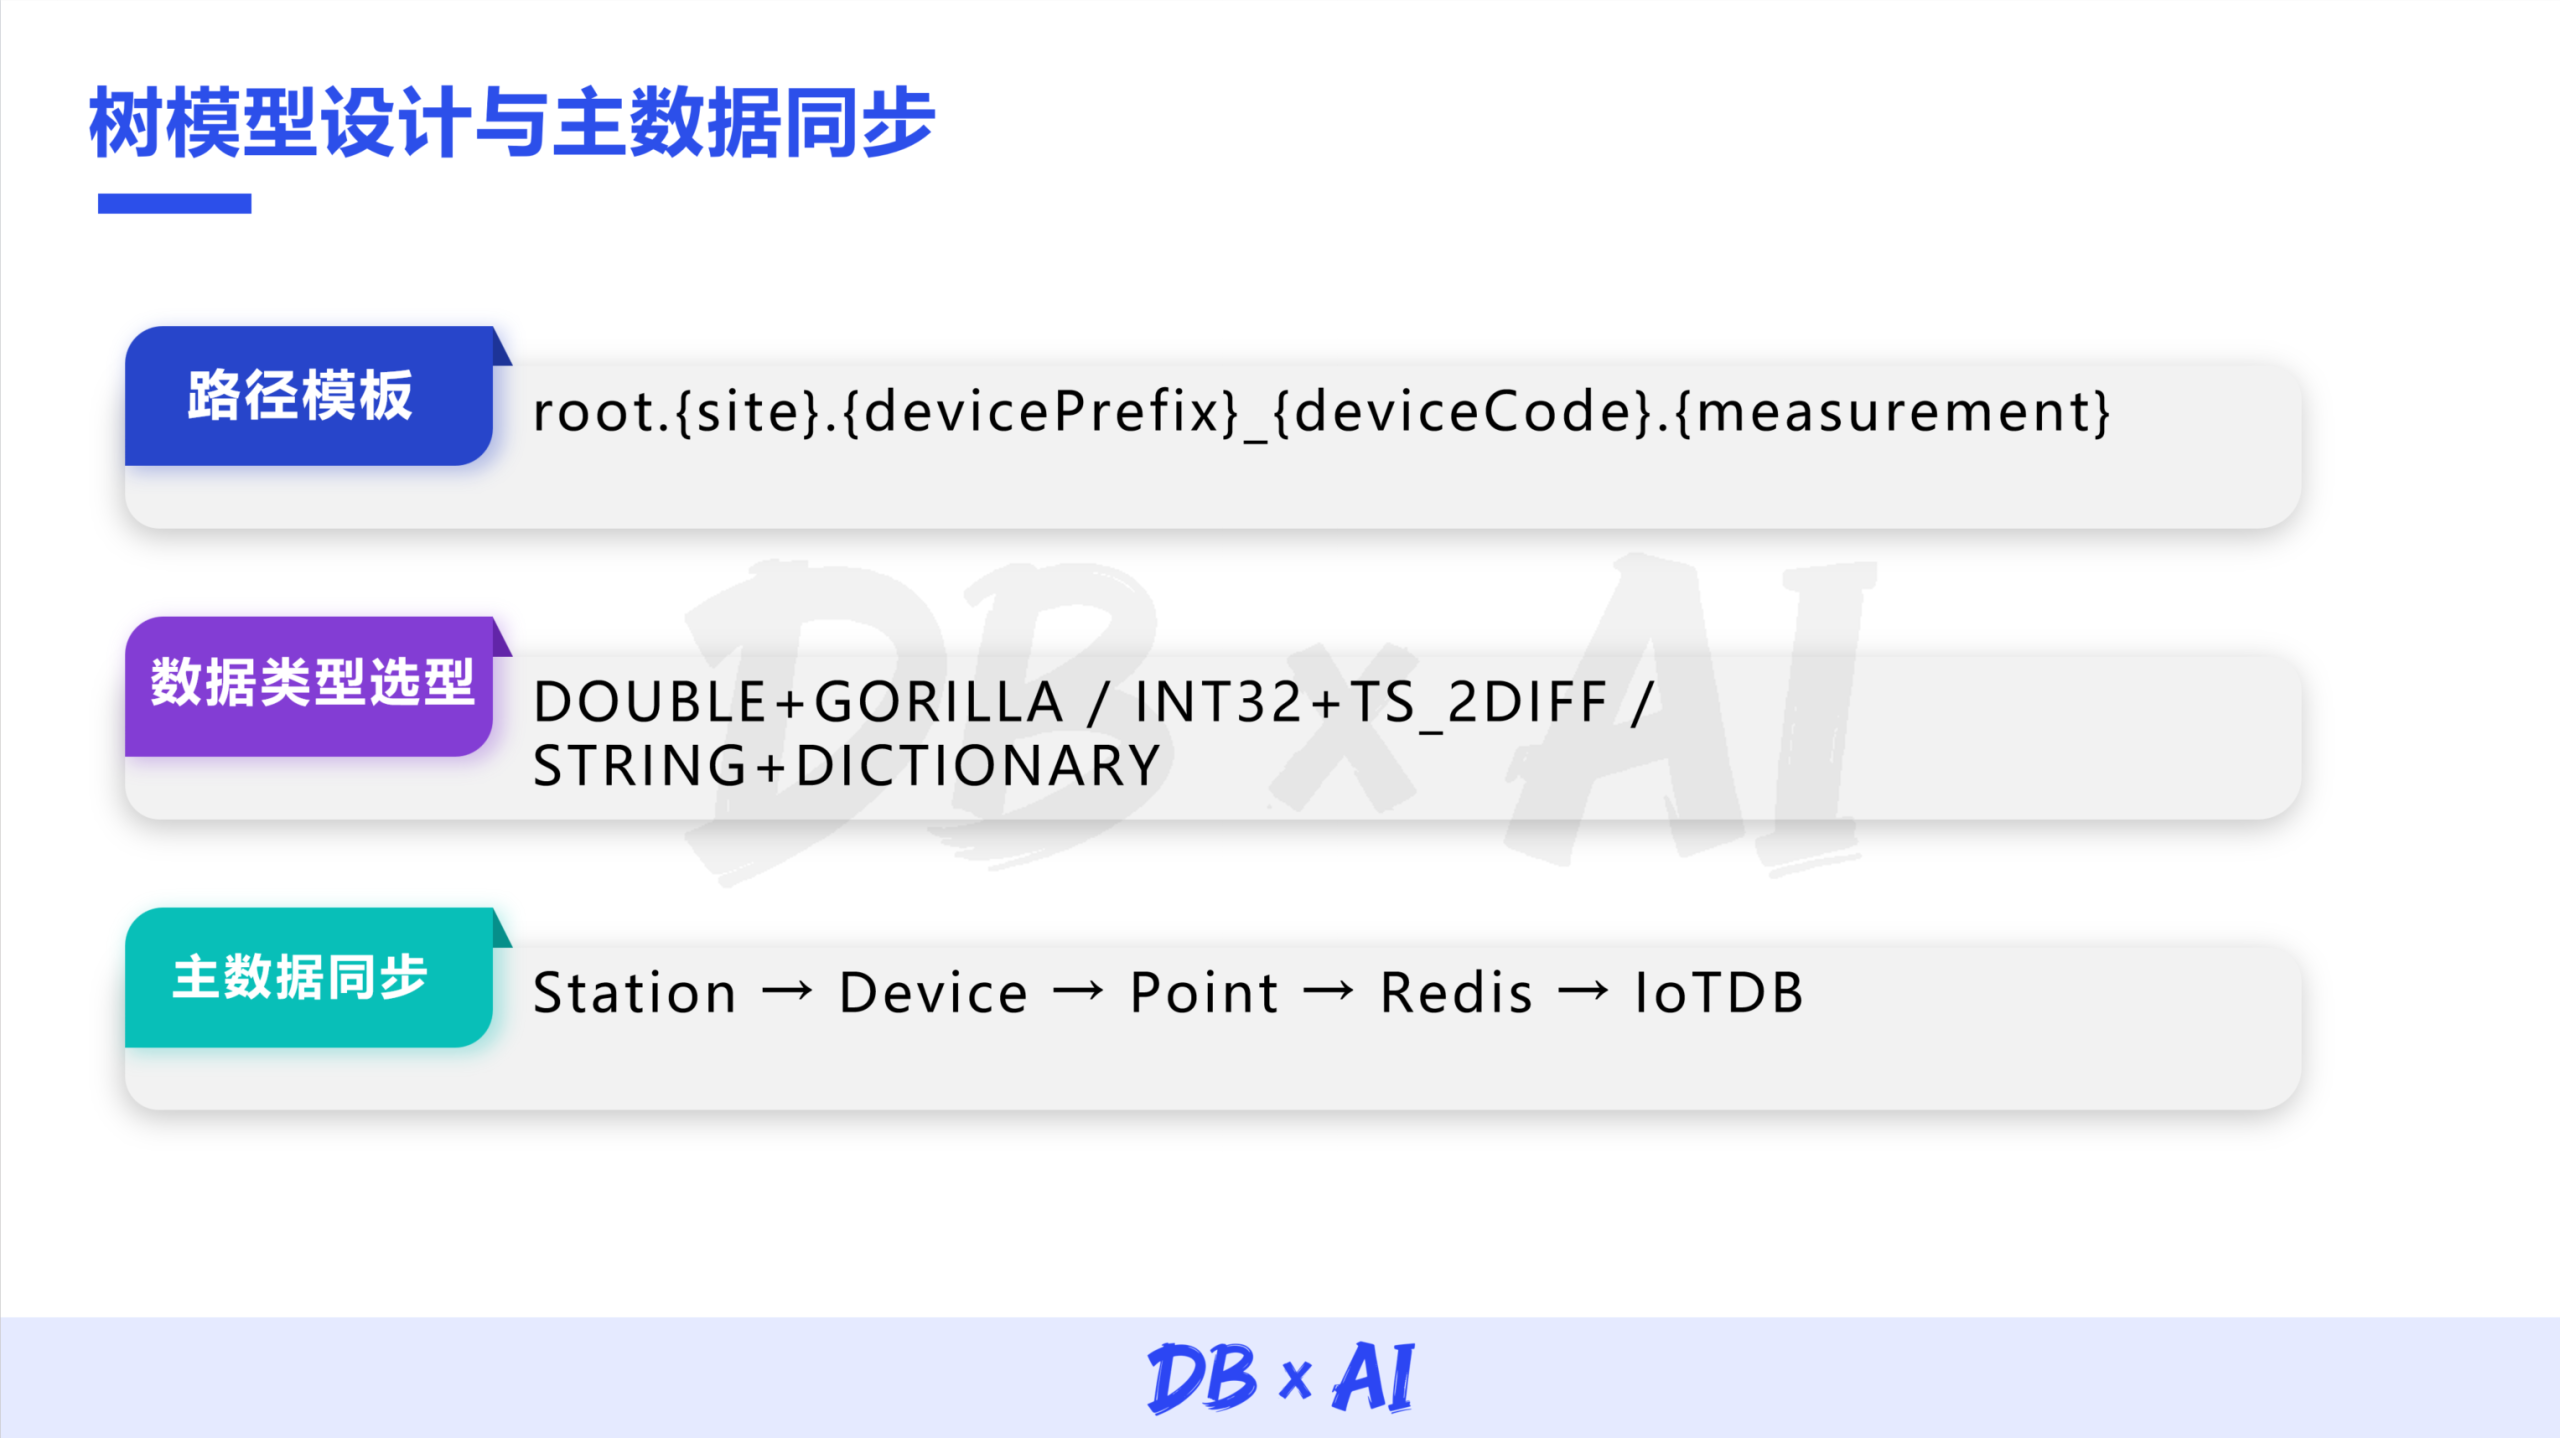
第一,先用业务拓扑设计时序路径。储能业务中的站点、设备、测点等层级,可以直接映射为 IoTDB 树模型中的路径结构,路径模板要在接入前约定,并确保设备编码与物理量可追溯。
第二,把弱网补传当成链路设计的一部分。压缩编码、本地离线缓存、恢复后的限速补传和告警转发需要一起设计,不能只在数据库写入环节解决问题。
第三,用真实数据验证写入路径。原生插件和API都可以先测再选,批量阈值、SessionPool 连接方式和线程模型,应当以实际设备规模与数据频率为依据。
第四,把迁移验收写成清单。除了检查元数据和数据量,还要核对文件层与业务层;对基于 TsFile 的迁移,应结合具体版本和加载方式,检查数据文件及其相关元数据、修改文件、加载路径和目标数据库等事项。以上方法来自本项目实践,具体参数仍需结合设备、网络和集群配置验证。
七、从一条项目链路看IoTDB的价值
从这次实践可以看到,IoTDB 的价值不能只用单项性能指标衡量。在该项目中,IoTDB 承担了时序数据组织、高吞吐写入、实时与历史查询、聚合导出和 TsFile 批量加载等核心任务;边缘缓存、MQTT、转码服务、Redis和应用层控制规则,则共同补齐端到端系统所需的工程保障。
树形模型能否贴合设备层级,断网后能否补传,批量写入和热点查询能否稳定运行,控制指令能否闭环确认,TB 级历史数据能否经过验证后迁移,这些具体问题共同决定了系统能否长期支撑储能业务。
华冬进的分享提供了一套经过实际项目检验的“接、管、用、迁”思路。它没有把 IoTDB 描述成独立于业务的单一组件,而是展示了数据库能力如何与边缘网络、云端服务和运维机制协同。对于正在建设储能数据平台的团队而言,这套实践既是一则案例,也是一份可以带回项目现场复核的技术清单。


